در بسیاری از این قابلیتها، هوش مصنوعی نقش اصلی را دارد اما برخلاف چیزی که شاید از نام آن تصور کنیم، پشت هوش مصنوعی یک «ذهن دیجیتالی همهچیزدان» قرار ندارد. این فناوری با استفاده از دادهها، الگوریتمها و مدلهای محاسباتی، الگوهای موجود در اطلاعات را شناسایی میکند و از آنها برای انجام کارهایی مانند دستهبندی، پیشبینی، تصمیمگیری یا تولید محتوای تازه استفاده میکند.
هوش مصنوعی (Artificial Intelligence یا AI) شاخهای از علوم رایانه و مهندسی است که به ساخت سیستمهایی میپردازد که میتوانند از ورودیهای دریافتی، خروجیهایی مانند پیشبینی، پیشنهاد، تصمیم یا محتوا تولید کنند.
جان مککارتی (John McCarthy)، دانشمند علوم رایانه و یکی از بنیانگذاران این رشته، هوش مصنوعی را «علم و مهندسی ساخت ماشینهای هوشمند، بهویژه برنامههای رایانهای هوشمند» تعریف میکرد. نکته مهم در توضیح او این بود که یک ماشین برای هوشمند نامیده شدن مجبور نیست دقیقاً مانند مغز انسان کار کند.
پس وقتی میپرسیم «هوش مصنوعی چیست؟» فقط درباره رباتها یا چتباتها حرف نمیزنیم. سامانه تشخیص هرزنامه، مترجم ماشینی، موتور پیشنهاددهنده، ابزار تولید تصویر و سیستم تشخیص اشیا در عکس هم میتوانند نمونههایی از AI باشند.
در این راهنما، قدمبهقدم وارد سازوکار هوش مصنوعی میشویم؛ از داده و آموزش مدل شروع میکنیم، انواع و شاخههای AI را میشناسیم و بعد به کاربردها، خطرها، آینده مشاغل و مسیر یادگیری آن میرسیم.
مرز هوش مصنوعی با برنامههای معمولی کجاست؟
برای شناخت هوش مصنوعی باید دو موضوع را از هم جدا کنیم: «انجام یک کار هوشمندانه» و «فکر کردن مانند انسان».
برای مثال وقتی یک مدل هوش مصنوعی، تصویر گربه را تشخیص میدهد، لزوماً نمیداند گربه چه حیوانی است، چه رفتاری دارد یا چرا بعضی افراد از آن نگهداری میکنند. مدل فقط آموخته است که برخی الگوهای تصویری با برچسب «گربه» ارتباط بیشتری دارند.
وقتی یک چتبات هم شعری درباره باران مینویسد، نمیتوان نتیجه گرفت که خاطره یا احساسی درباره باران دارد. مدل از الگوهای موجود در زبان استفاده میکند تا متنی شبیه نوشتههای انسانی بسازد.
سازمان همکاری و توسعه اقتصادی (OECD) سیستم هوش مصنوعی را سامانهای ماشینمحور تعریف میکند که برای رسیدن به هدفهای آشکار یا ضمنی، از ورودیها نتیجه میگیرد چگونه خروجیهایی مانند پیشبینی، محتوا، پیشنهاد یا تصمیم تولید کند.
اگرچه این تعریف کمی رسمی به نظر میرسد اما میتوانیم آن را سادهتر کنیم: یک سیستم هوش مصنوعی اطلاعاتی دریافت میکند، میان اطلاعات، دنبال الگو و ارتباط میگردد و براساس نتیجهای که به دست میآورد، پاسخی تولید میکند یا کاری انجام میدهد.
در همان مثال پیام مشکوک، متن پیام، فرستنده و لینکهای داخل آن ورودی سیستم هستند. مدل این اطلاعات را بررسی میکند و در پایان، احتمال میدهد پیام سالم یا ناخواسته است.
همه سیستمهای AI هم به یک اندازه مستقل نیستند. بعضی فقط پیشنهادی در اختیار انسان میگذارند و منتظر تصمیم او میمانند. بعضی دیگر میتوانند در محدودهای مشخص، کاری را خودکار انجام دهند. هرچه نتیجه تصمیم حساستر باشد، نظارت انسان اهمیت بیشتری پیدا میکند.
آیا هر برنامه خودکاری هوش مصنوعی است؟
خیر. اگر برنامهای دو عدد را جمع کند یا براساس فرمولی ثابت معدل شما را به دست آورد، معمولاً با هوش مصنوعی روبهرو نیستیم. چنین برنامهای دستورهایی را اجرا میکند که برنامهنویس از قبل نوشته است.
به قول معروف، هر گردی گردو نیست؛ هر برنامه خودکاری هم هوش مصنوعی نیست.
البته مرز میان برنامه معمولی، اتوماسیون و AI همیشه کاملاً مشخص نیست. بعضی سیستمهای قدیمی هوش مصنوعی، مانند سیستمهای خبره (Expert Systems)، با مجموعه بزرگی از قواعد «اگر… آنگاه…» کار میکردند.
برای مثال، یک سیستم میتوانست این قواعد را داشته باشد:
- اگر دمای دستگاه از حد مشخصی بیشتر شد، هشدار بده
- اگر فشار همزمان افزایش یافت، احتمال خرابی را بررسی کن
- اگر چند نشانه با هم دیده شدند، موضوع را به متخصص گزارش بده
در این روش، انسان دانش خود را بهصورت قواعد وارد سیستم میکند. بسیاری از مدلهای جدید مسیر دیگری دارند: بهجای اینکه تمام حالتهای ممکن برایشان نوشته شود، با دیدن نمونههای مختلف، الگوها را از داده یاد میگیرند. اینجا همان نقطهای است که به مفهوم یادگیری ماشین میرسیم.
هوش مصنوعی چگونه کار میکند؟
همه سیستمهای هوش مصنوعی شبیه به هم کار نمیکنند. یک سیستم خبره، موتور پیشنهاددهنده و مدل زبانی بزرگ میتوانند ساختارهای کاملاً متفاوتی داشته باشند. با این حال، برای شناخت بسیاری از سیستمهای امروزی باید سه مفهوم را بشناسید: داده، الگوریتم و مدل.
برای اینکه این مفاهیم نامأنوس نباشند، دوباره به مثال پیام مشکوک ابتدای مقاله برگردیم. فرض کنید میخواهید برنامهای بسازید که پیامهای ناخواسته را تشخیص دهد. باید از کجا شروع کنید؟
داده؛ نمونههایی که سیستم از آنها یاد میگیرد
ابتدا به تعدادی پیام سالم و ناخواسته نیاز دارید. این نمونهها داده (Data) پروژه شما هستند. متن پیام، تعداد لینکها، نشانی فرستنده و زمان ارسال همگی میتوانند بخشی از داده باشند.
اگر کنار هر پیام مشخص کنید که سالم یا ناخواسته است، به آن یک برچسب (Label) دادهاید. مدل در زمان آموزش تلاش میکند رابطه میان محتوای پیام و برچسب آن را پیدا کند.
زیاد بودن داده و اطلاعات همیشه به معنای بهتر بودن آن نیست. فرض کنید تمام پیامهای ناخواستهای که جمع کردهاید عبارت «برنده شدهاید» داشته باشند. مدل ممکن است بیش از حد به همین عبارت وابسته شود. بعداً شاید یک پیام واقعی درباره برنده شدن در مسابقه را اشتباه تشخیص دهد یا پیام مشکوکی را که این عبارت را ندارد، سالم بداند.
پس داده باید تا حد ممکن درست، مرتبط و متنوع باشد. مدل فقط میتواند از اطلاعاتی یاد بگیرد که در اختیارش قرار گرفته است.
الگوریتم؛ روشی که یادگیری را هدایت میکند
الگوریتم (Algorithm) مجموعهای از مراحل محاسباتی برای حل یک مسئله است. در پروژه تشخیص هرزنامه، الگوریتم مشخص میکند مدل چگونه پیامها را بررسی کند، پاسخ خود را با جواب درست مقایسه کند و از خطاهایش برای بهتر شدن کمک بگیرد.
الگوریتم و مدل باهم تفاوت دارند. الگوریتم، روش یادگیری است و مدل، نتیجهای است که پس از اجرای این روش روی دادهها به دست میآید. در ادامه درباره مفهوم مدل، بیشتر یاد میگیریم.
مدل؛ چیزی که پس از آموزش استفاده میکنیم
مدل (Model) بخشی از سیستم است که ورودی تازه را دریافت و خروجی تولید میکند. وقتی آموزش تمام شد، مدل تشخیص هرزنامه میتواند یک پیام جدید را بررسی کند و احتمال دهد که آن پیام سالم یا مشکوک است.
| مفهوم |
توضیح ساده |
نمونه در تشخیص هرزنامه |
| داده (Data) | نمونههایی که سیستم بررسی میکند | پیامهای سالم و ناخواسته |
| برچسب (Label) | پاسخ درست هر نمونه | «سالم» یا «هرزنامه» |
| ویژگی (Feature) | اطلاعاتی که به پیدا کردن الگو کمک میکند | واژهها، فرستنده یا تعداد لینکها |
| الگوریتم (Algorithm) | روش یادگیری و اصلاح خطا | تنظیم مدل براساس پاسخهای درست و غلط |
| مدل (Model) | نتیجه آموزش که برای پیشبینی استفاده میشود | تشخیص وضعیت پیام تازه |
| خروجی (Output) | پاسخ نهایی سیستم | برچسب یا احتمال هرزنامه بودن |
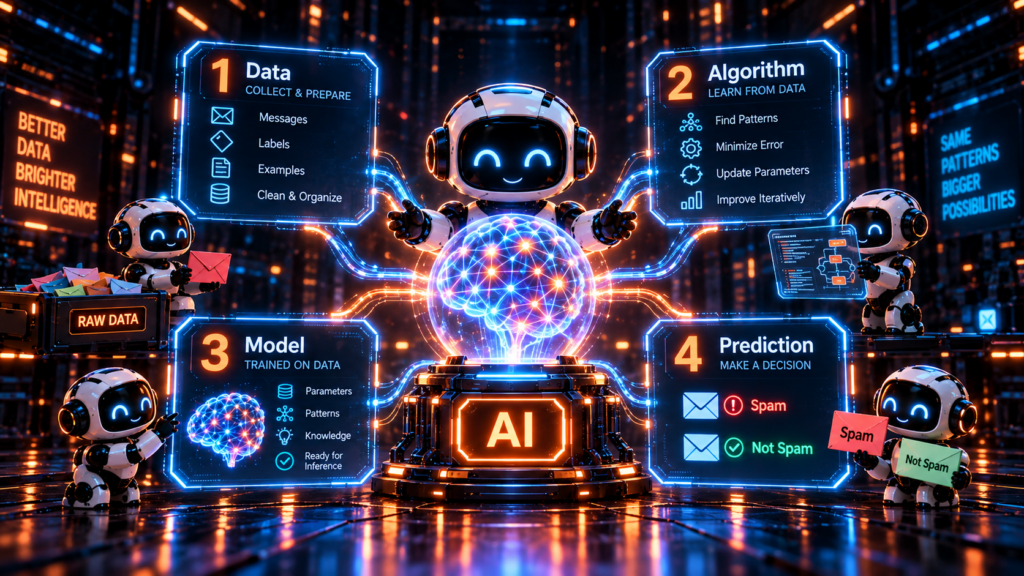
رابطه این مفاهیم را میتوان اینطور دید: یک مدل چگونه آموزش میبیند؟
در بسیاری از مدلهای یادگیری ماشین، مقادیری به نام پارامتر (Parameter) وجود دارند. این پارامترها روی رفتار مدل اثر میگذارند و مشخص میکنند سیستم هنگام بررسی ورودی، به اطلاعات مختلف چه اهمیتی بدهد.
در شروع آموزش، مدل هنوز تنظیم مناسبی ندارد. یک پیام را بررسی میکند و پاسخی میدهد. سپس پاسخ آن با برچسب درست مقایسه میشود. اگر مدل اشتباه کرده باشد، الگوریتم آموزش، پارامترهای آن را کمی تغییر میدهد. این کار بارها با نمونههای مختلف تکرار میشود تا خطای مدل کمتر شود.
هدف فقط کم کردن اشتباه روی پیامهایی نیست که مدل قبلاً دیده است. مدل باید بتواند پیامهای تازه را هم درست تشخیص دهد. به توانایی استفاده از الگوهای آموختهشده در نمونههای جدید، تعمیم (Generalization) گفته میشود.
ساخت یک سیستم هوش مصنوعی معمولاً از این مسیر عبور میکند:
- مسئله بهصورت دقیق مشخص میشود.
- دادههای مرتبط جمعآوری و بررسی میشوند.
- نمونههای اشتباه، تکراری یا نامناسب تا حد امکان اصلاح میشوند.
- الگوریتم و مدل متناسب با مسئله انتخاب میشوند.
- مدل با بخشی از دادهها آموزش میبیند.
- عملکرد آن روی دادههای جداگانه سنجیده میشود.
- اگر نتیجه مناسب باشد، سیستم در محیط واقعی قرار میگیرد.
- عملکرد مدل پس از شروع استفاده نیز بررسی میشود.
مرحله آخر را نباید نادیده گرفت. نوع پیامهای ناخواسته، رفتار کاربران و شرایط محیط با گذشت زمان تغییر میکنند. ممکن است مدلی که امروز عملکرد خوبی دارد، مدتی بعد در تشخیص نمونههای تازه، ضعیفتر شود. به همین دلیل، بررسی مدل پس از شروع استفاده نیز بخشی از چرخه عمر هوش مصنوعی (AI Lifecycle) است.
سه نوع داده مهم در آموزش یادگیری ماشین
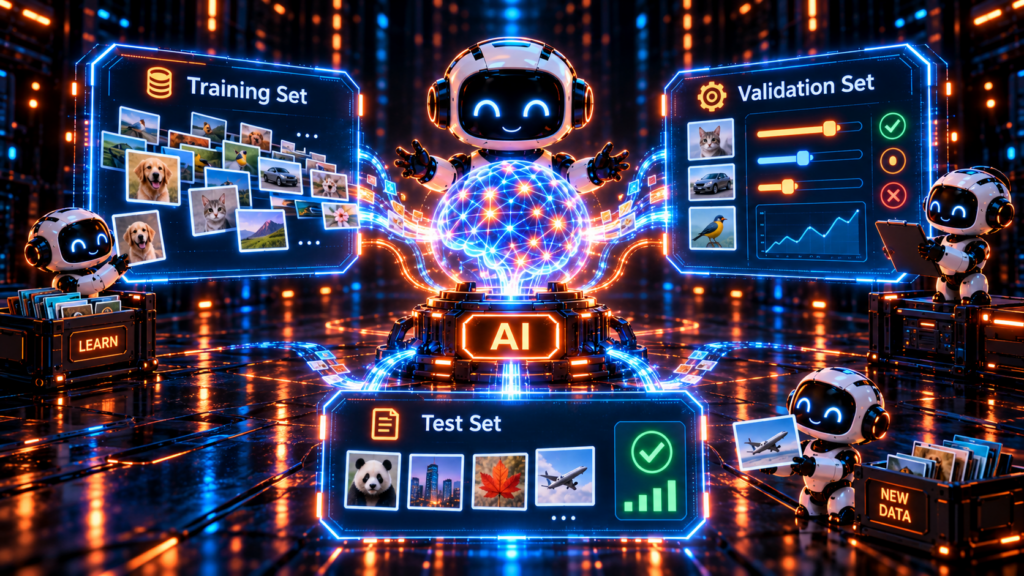
اگر تمام دادهها را یکجا به مدل بدهیم، نمیتوانیم با اطمینان بفهمیم واقعاً چیزی یاد گرفته یا فقط نمونهها را حفظ کرده است. برای حل این مشکل، دادهها معمولاً به سه بخش تقسیم میشوند:
- مجموعه آموزش (Training Set): نمونههایی که مدل با کمک آنها الگوها را یاد میگیرد؛ شبیه تمرینهایی که پیش از امتحان حل میکنید.
- مجموعه اعتبارسنجی (Validation Set): نمونههایی که در میانه کار برای بررسی مدل استفاده میشوند. نتیجه این بررسی به سازندگان کمک میکند تنظیمات مناسبتری انتخاب کنند.
- مجموعه آزمون (Test Set): دادههای تازهای که مدل هنگام آموزش و تنظیم ندیده است. در پایان، این دادهها نشان میدهند مدل در برخورد با نمونههای جدید چه عملکردی دارد.
میتوانید مجموعه آموزش را تمرینهای کتاب، مجموعه اعتبارسنجی را آزمون آزمایشی و مجموعه آزمون را برگهای در نظر بگیرید که سؤالهایش را از قبل ندیدهاید. البته مدل مانند یک دانشآموز فکر نمیکند؛ این مثال فقط تفاوت نقش دادهها را روشن میکند.
مفاهیم بیش برازش و کمبرازش در یادگیری ماشین
اگر مدل پاسخ نمونههای آموزشی را حفظ کند، ممکن است روی همان نمونهها عملکرد بسیار خوبی داشته باشد، اما با کمی تغییر در ورودی شکست بخورد. به این مشکل بیشبرازش (Overfitting) گفته میشود.
تصور کنید جواب تمام تمرینهای یک جزوه را حفظ کردهاید اما مفهوم درس را نفهمیدهاید. تا زمانی که همان سؤالها تکرار شوند، نتیجه خوبی میگیرید؛ با عوض شدن صورت سؤال، پاسخ دادن دشوار میشود.
مشکل دیگری که ممکن است رخ دهد، کمبرازش (Underfitting) است. در این حالت، مدل هنوز الگوهای اصلی را بهخوبی یاد نگرفته و حتی روی دادههای آموزشی هم عملکرد مناسبی ندارد. یک مدل کارآمد باید الگوهای مهم را یاد بگیرد، بدون اینکه فقط نمونههای قبلی را حفظ کند.
آموزش و استنتاج در یادگیری ماشین چه تفاوتی دارند؟
آموزش (Training) مرحلهای است که مدل دادهها را بررسی میکند و پارامترهایش تغییر میکنند. آموزش مدلهای بزرگ میتواند به داده، زمان، انرژی و توان پردازشی زیادی نیاز داشته باشد.
پس از آموزش، نوبت استفاده از مدل میرسد. وقتی مدل ورودی تازهای دریافت میکند و پاسخ میدهد، استنتاج (Inference) انجام شده است. بررسی یک پیام جدید یا تشخیص چهره برای باز کردن قفل گوشی، نمونههایی از استنتاج هستند.
مدل لزوماً از هر ورودی تازه فوراً یاد نمیگیرد. اینکه گفتوگوها، تصاویر یا اطلاعات کاربران بعداً برای بهبود یک محصول استفاده شوند، به ساختار فنی، تنظیمات حساب و سیاست حفظ حریم خصوصی همان سرویس بستگی دارد.
چرا AI همیشه یک پاسخ ثابت نمیدهد؟
بسیاری از مدلهای هوش مصنوعی با احتمالها کار میکنند. یک مدل تشخیص تصویر ممکن است محاسبه کند که تصویر با احتمال بیشتری گربه است تا روباه. مدل زبانی نیز برای ادامه هر جمله، چند گزینه احتمالی را بررسی میکند.
فرض کنید از یک ابزار مولد بخواهید برای شخصیت بازی شما نام پیشنهاد دهد. نامهای «آذرخش»، «سایهگرد» و «نگهبان مه» ممکن است همگی با توضیحتان هماهنگ باشند. مدل میتواند هر بار یکی از گزینههای محتمل را انتخاب کند. به همین دلیل، ممکن است یک درخواست را دو بار مطرح کنید و جوابهای کمی متفاوتی بگیرید.
این ویژگی بهخودیخود اشکال محسوب نمیشود؛ برای ایدهپردازی حتی میتواند مفید باشد. مسئله زمانی آغاز میشود که روان بودن پاسخ را با درست بودن آن اشتباه بگیریم. در بخش خطرهای AI میبینیم که چرا مدل گاهی اطلاعات نادرست را هم با جملهبندی قانعکننده بیان میکند.
انواع هوش مصنوعی چیست؟
به همان مثال تشخیص «هرزنامه» برگردیم. مدل تشخیص هرزنامه ممکن است در پیدا کردن پیامهای مشکوک بسیار موفق باشد اما آیا میتواند فقط بهدلیل همین موفقیت برای شما بازی طراحی کند، مسئله هندسه حل کند یا درباره یک رویداد تاریخی توضیح بدهد؟ احتمالاً نه.
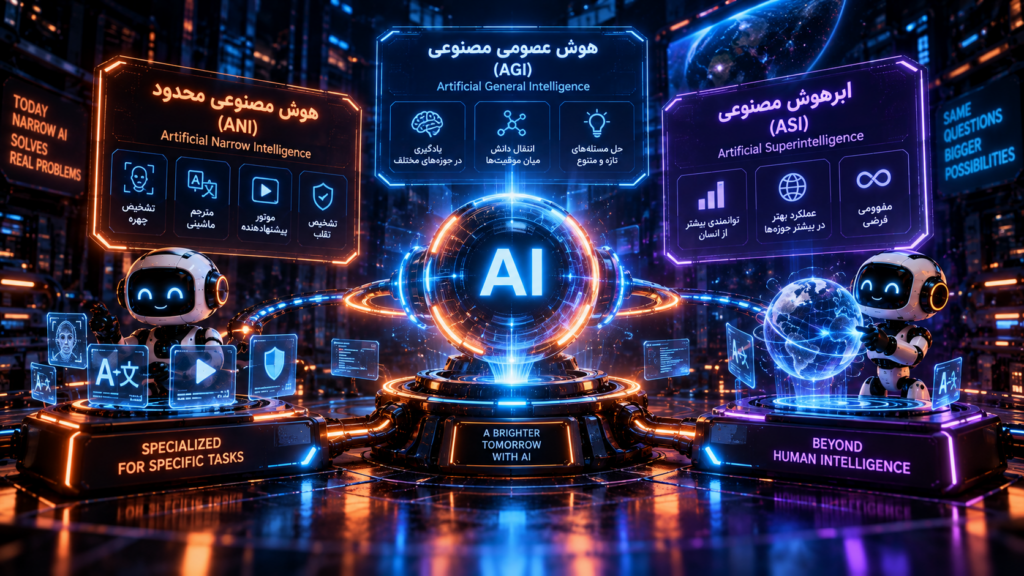
یکی از راههای شناخت انواع هوش مصنوعی این است که ببینیم هر سیستم چه تعداد و چه نوع کاری میتواند انجام دهد. براساس یک دستهبندی رایج، از هوش مصنوعی محدود، هوش عمومی مصنوعی و ابرهوش مصنوعی صحبت میشود. این تقسیمبندی برای توضیح تفاوت تواناییها مفید است اما مرزهای آن مورد توافق کامل همه پژوهشگران نیست.
هوش مصنوعی محدود
هوش مصنوعی محدود (Artificial Narrow Intelligence یا ANI) برای انجام یک کار یا مجموعهای مشخص از کارها ساخته میشود. بیشتر سیستمهایی که با آنها روبهرو هستیم، در این گروه قرار میگیرند.
مدل تشخیص چهره، مترجم ماشینی، موتور پیشنهاددهنده، سامانه تشخیص تقلب و ابزار تولید تصویر نمونههایی از هوش مصنوعی محدود هستند. هرکدام ممکن است در محدوده خود توانمند باشند اما موفقیت در یک کار به معنای برخورداری از هوش عمومی انسانی نیست.
برخی مدلهای جدید میتوانند متن، تصویر، صدا و ویدئو را پردازش کنند. به چنین مدلهایی چندوجهی (Multimodal) گفته میشود. چندوجهی بودن، دامنه ورودی و خروجی را افزایش میدهد اما بهتنهایی ثابت نمیکند که مدل مانند انسان جهان را میفهمد.
هوش عمومی مصنوعی
هوش عمومی مصنوعی (Artificial General Intelligence یا AGI) اصطلاحی برای سیستمی فرضی است که بتواند تواناییهای شناختی عمومی را در مسائل مختلف به کار بگیرد، آموختههایش را میان موقعیتهای متفاوت منتقل کند و با مسئلههای تازه انعطافپذیرانه روبهرو شود.
درباره تعریف دقیق AGI و روش اندازهگیری آن اتفاقنظر کاملی وجود ندارد. به همین دلیل، ادعاهای مربوط به رسیدن یک سیستم به هوش عمومی باید با توجه به معیارها و شواهد آن بررسی شوند، نه فقط براساس توانایی مدل در گفتوگو یا موفقیت در چند آزمون.
ابرهوش مصنوعی
ابرهوش مصنوعی (Artificial Superintelligence یا ASI) مفهومی فرضی برای توصیف سیستمی است که در بیشتر یا همه فعالیتهای شناختی از انسان توانمندتر باشد. ابرهوش در حال حاضر مفهومی نظری است و نباید آن را با چتباتها یا مدلهای مولد موجود یکی بدانید.
ANI، AGI و ASI نیز مراحل قطعی رشد یک محصول نیستند. ممکن است یک مدل در چند آزمون از بسیاری از انسانها بهتر عمل کند، اما در مسئلهای ساده و کمی متفاوت دچار اشتباه شود.
تفاوت هوش مصنوعی، یادگیری ماشین و یادگیری عمیق
هوش مصنوعی، یادگیری ماشین، یادگیری عمیق، هوش مصنوعی مولد و مدل زبانی بزرگ ارتباط نزدیکی با یکدیگر دارند اما هممعنی نیستند.
برای فهم رابطه آنها، چند دایره را تصور کنید که بعضی داخل یکدیگر قرار گرفتهاند. دایره بزرگتر، هوش مصنوعی است. یادگیری ماشین بخشی از آن است و یادگیری عمیق نیز درون یادگیری ماشین قرار میگیرد.
|
مفهوم |
تعریف ساده |
نمونه |
| هوش مصنوعی (AI) | قلمرو کلی ساخت سیستمهایی که میتوانند استنتاج، پیشبینی، برنامهریزی یا تصمیمگیری کنند | سیستم خبره یا برنامهریزی مسیر |
| یادگیری ماشین (ML) | یادگیری الگو از داده | تشخیص پیام ناخواسته |
| یادگیری عمیق (DL) | یادگیری با شبکههای عصبی چندلایه | تشخیص اشیا در تصویر |
| هوش مصنوعی مولد (Generative AI) | ساخت محتوایی مانند متن، تصویر یا صدا | تولید تصویر از توضیح متنی |
| مدل زبانی بزرگ (LLM) | مدلی برای پردازش و تولید زبان | پاسخگویی، ترجمه یا خلاصهسازی |
هوش مصنوعی (AI) مفهوم گستردهای است و روشهایی مانند قواعد منطقی، جستوجو، برنامهریزی و یادگیری از داده را دربرمیگیرد.
یادگیری ماشین (Machine Learning یا ML) بخشی از هوش مصنوعی است که در آن سیستم، الگوها را با استفاده از داده یاد میگیرد. در این روش لازم نیست برنامهنویس تمام حالتهای ممکن را جداگانه بنویسد.
یادگیری عمیق (Deep Learning یا DL) بخشی از یادگیری ماشین است که از شبکههای عصبی چندلایه استفاده میکند. این روش در پردازش تصویر، زبان و صدا نقش مهمی دارد.
پس هر مدل یادگیری عمیق، نوعی مدل یادگیری ماشین است و هر یادگیری ماشینی در قلمرو هوش مصنوعی قرار میگیرد؛ اما همه سیستمهای AI از یادگیری ماشین استفاده نمیکنند.
شبکه عصبی چگونه کار میکند؟
برای شناخت یادگیری عمیق باید با شبکه عصبی مصنوعی (Artificial Neural Network) آشنا شوید. شبکه عصبی نوعی مدل محاسباتی است که از چند لایه واحدهای پردازشی تشکیل میشود.
فرض کنید تصویری وارد شبکه شده است. رایانه ابتدا تصویر را به مجموعهای از عددها تبدیل میکند. هر واحد پردازشی بخشی از این عددها را دریافت میکند، آنها را براساس اهمیتشان میسنجد و نتیجه را به لایه بعد میفرستد.
اهمیت هر ارتباط با عددی به نام وزن (Weight) مشخص میشود. در ابتدای آموزش، وزنها هنوز تنظیم مناسبی ندارند. مدل پاسخ میدهد، خطای آن محاسبه میشود و وزنها کمی تغییر میکنند. با تکرار این روند، شبکه بهتدریج الگوهای مفیدتری را یاد میگیرد.
برای اینکه این مفهوم را بهتر متوجه شوید، میتوانید وزنها را مانند پیچهای تنظیم در نظر بگیرید. الگوریتم آموزش هر بار آنها را کمی تغییر میدهد تا خروجی مدل به پاسخ درست نزدیکتر شود. این فقط یک تشبیه برای ساده شدن مفهوم است؛ تغییر وزنها در عمل با محاسبات ریاضی انجام میشود.
نام شبکه عصبی از نورونها و شبکههای عصبی زیستی الهام گرفته شده اما این فناوری نسخه دیجیتالی کامل مغز نیست. شبکه عصبی یک مدل ریاضی و مهندسی است و شباهت آن به مغز محدود است.
در یک مدل تشخیص تصویر، لایههای ابتدایی ممکن است الگوهای سادهای مانند لبهها و بافتها را پردازش کنند و لایههای بعدی به ترکیبهای پیچیدهتری برسند. با این حال، همه چیزهایی که شبکه یاد میگیرد همیشه بهآسانی برای انسان قابل توضیح نیست.
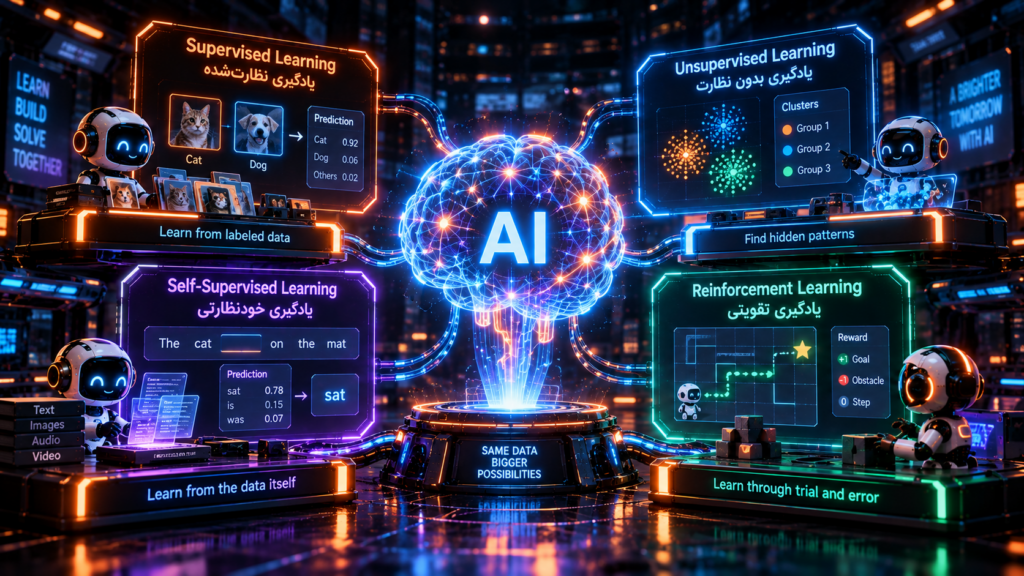
انواع یادگیری ماشین؛ مدلها به چه روشهایی یاد میگیرند؟
همه مدلها به یک روش یاد نمیگیرند. شیوه یادگیری آنها به نوع مسئله، دادههای موجود و بازخوردی بستگی دارد که دریافت میکنند.
انواع یادگیری ماشین:
- یادگیری نظارت شده
- یادگیری بدون نظارت
- یادگیری خودنظارتی
- یادگیری تقویتی
در یادگیری نظارتشده (Supervised Learning)، پاسخ درست نمونهها مشخص است. همان پیامهای دارای برچسب «سالم» و «هرزنامه» نمونهای از این روش هستند. مدل با دیدن این نمونهها یاد میگیرد برای ورودی تازه چه برچسبی را پیشبینی کند.
یادگیری نظارتشده معمولاً در دو نوع مسئله کاربرد دارد. در طبقهبندی (Classification)، مدل یک گروه یا برچسب را پیشبینی میکند؛ مانند سالم یا ناخواسته بودن پیام. در رگرسیون (Regression)، خروجی معمولاً یک مقدار عددی است؛ مانند برآورد زمان رسیدن.
در یادگیری بدون نظارت (Unsupervised Learning)، پاسخ درست از قبل مشخص نشده است. فرض کنید تعداد زیادی آهنگ دارید، اما برایشان دستهبندی تعیین نکردهاید. الگوریتم میتواند براساس ویژگیهای عددی، آهنگهای شبیهتر را کنار یکدیگر قرار دهد. به این کار خوشهبندی (Clustering) گفته میشود. اینکه هر گروه دقیقاً چه معنایی دارد، همچنان باید بررسی و تفسیر شود.
در یادگیری خودنظارتی (Self-Supervised Learning)، بخشی از خود داده نقش پاسخ آموزشی را پیدا میکند. برای مثال، مدل بخشی از یک جمله را پنهان میکند و تلاش میکند آن را از روی قسمتهای باقیمانده پیشبینی کند. بسیاری از مدلهای زبانی بزرگ در مرحله اصلی آموزش از روشهای خودنظارتی استفاده میکنند.
در یادگیری تقویتی (Reinforcement Learning یا RL)، یک عامل (agent) با محیط تعامل میکند، کاری انجام میدهد و پاداش یا بازخورد میگیرد. برای مثال یک شخصیت بازی را تصور کنید که باید از موانع عبور کند و به مقصد برسد. رسیدن به مقصد میتواند پاداش مثبت داشته باشد و برخورد با مانع نتیجه نامطلوبی ایجاد کند. عامل با تجربه موقعیتهای مختلف، رفتار خود را بهتر میکند.
این روشها رقیبهای مطلق یکدیگر نیستند. یک سیستم واقعی میتواند در مراحل مختلف با ترکیبی از چند روش آموزش ببیند.
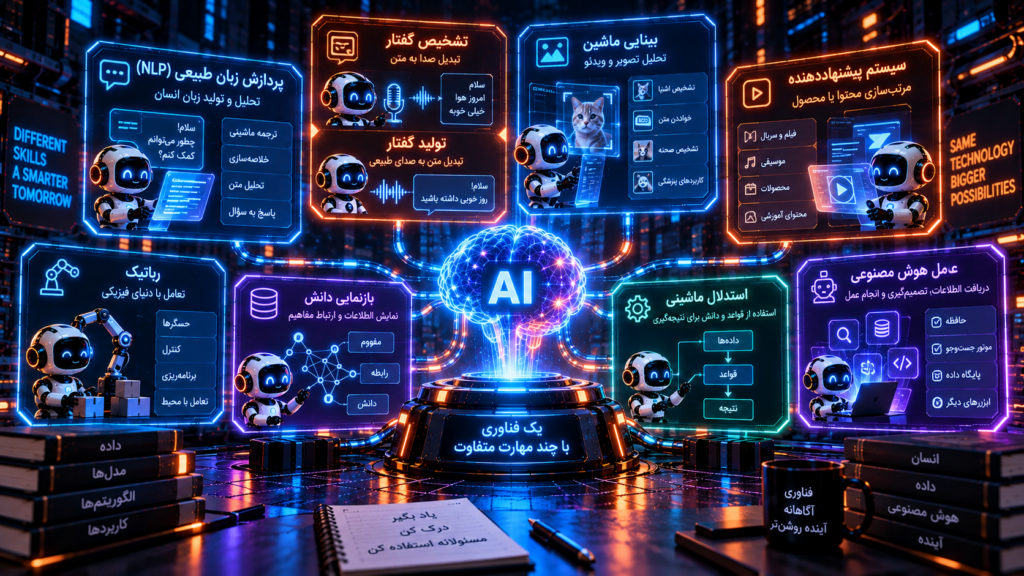
شاخههای هوش مصنوعی؛ یک فناوری با چند مهارت متفاوت
تا اینجا مدلهای هوش مصنوعی را شناختیم و فهمیدیم که چگونه از داده یاد میگیرند. حالا میتوانیم یک روز عادی را از نگاه هوش مصنوعی دنبال کنیم.
صبح با دستیار صوتی گوشی صحبت میکنید. سیستم ابتدا باید صدای شما را تشخیص دهد، آن را به متن تبدیل کند، معنی احتمالی درخواست را پیدا کند و پاسخ مناسبی بسازد.
از نگاه شما، همه این کارها داخل یک برنامه اتفاق میافتند اما پشت آنها شاخههای متفاوتی از AI قرار دارند.
زبان، صدا و تصویر
پردازش زبان طبیعی (Natural Language Processing یا NLP) به تحلیل و تولید زبان انسان مربوط است. ترجمه ماشینی، خلاصهسازی، تحلیل متن و پاسخگویی به سؤال در این شاخه قرار میگیرند.
زبان برای ماشین فقط مجموعهای از واژهها نیست. ارتباط میان کلمات، جای آنها در جمله و اطلاعات قبلی میتواند معنی را تغییر دهد. کنایه، ابهام و تفاوتهای فرهنگی نیز پردازش زبان را دشوار میکنند. برای مثال، معنی جمله «چه عالی!» همیشه مثبت نیست؛ لحن و موقعیت میتوانند معنای آن را تغییر دهند.
بینایی ماشین (Computer Vision) اطلاعات را از تصویر و ویدئو استخراج میکند. تشخیص اشیا، خواندن نوشته داخل عکس، جدا کردن بخشهای مختلف تصویر و بررسی تصاویر پزشکی از کاربردهای آن هستند.
برای مثال مدلی که توپ را در یک عکس پیدا میکند، لزوماً قوانین فوتبال را نمیداند. تشخیص یک الگوی تصویری با فهم کامل مفهوم آن یکسان نیست.
تشخیص گفتار (Speech Recognition) صدای انسان را به متن تبدیل میکند. تولید گفتار (Speech Synthesis) مسیر برعکس را طی میکند و از متن، صدای مصنوعی میسازد. این فناوریها در زیرنویس خودکار، دستیارهای صوتی و ابزارهای دسترسپذیری کاربرد دارند.
در محصولات مبتنی بر رباتیک (Robotics) حسگرها، اجزای مکانیکی، کنترل و برنامهریزی را برای تعامل با محیط فیزیکی ترکیب میکند. هر ربات الزاماً از AI استفاده نمیکند. یک بازوی صنعتی که همیشه حرکت ثابتی را تکرار میکند ممکن است فقط یک سیستم خودکار باشد. رباتی که مانع را میبیند، موقعیت خود را بررسی میکند و مسیرش را تغییر میدهد، میتواند از چند شاخه هوش مصنوعی کمک بگیرد.
سیستم پیشنهاددهنده (Recommender System) محتوا یا محصول را براساس اطلاعات موجود مرتب میکند. سابقه تعامل شما، ویژگیهای محتوا و رفتار کاربران دیگر میتوانند در این محاسبه نقش داشته باشند.
پیشنهاددهنده ذهن شما را نمیخواند؛ شباهتها و احتمالها را محاسبه میکند. به همین دلیل ممکن است گاهی سلیقهتان را اشتباه تشخیص دهد یا پس از دیدن چند ویدئوی مشابه، مدام همان نوع محتوا را به شما نشان دهد.
بازنمایی دانش (Knowledge Representation) اطلاعات و ارتباط میان مفاهیم را به شکلی نمایش میدهد که رایانه بتواند آنها را پردازش کند. استدلال ماشینی (Machine Reasoning) نیز از قواعد یا ساختارهای دانشی برای رسیدن به نتیجه استفاده میکند.
یک قدم جلوتر، به عامل هوشمند (Intelligent Agent) میرسیم. عامل هوشمند اطلاعاتی از محیط میگیرد، براساس هدف تصمیم میگیرد و عملی انجام میدهد.
یک عامل هوش مصنوعی (AI Agent) ممکن است علاوه بر مدل زبانی، به حافظه، موتور جستوجو، پایگاه داده یا نرمافزارهای دیگر متصل باشد. برای مثال، میتواند اطلاعات لازم را پیدا کند، آنها را بررسی کند و نتیجه را در یک فایل قرار دهد.
اتصال مدل به ابزارهای مختلف توانایی آن را افزایش میدهد اما ریسک را نیز بیشتر میکند. مدلی که فقط متن پیشنهاد میدهد با عاملی که اجازه ارسال پیام، اجرای کد یا تغییر فایل دارد، سطح خطر یکسانی ندارد. هرچه سیستم اختیار بیشتری داشته باشد، محدود کردن دسترسی و نظارت انسان مهمتر میشود.
هوش مصنوعی مولد چیست؟
تا اینجا بیشتر درباره سیستمهایی حرف زدیم که چیزی را تشخیص میدهند، دستهبندی میکنند یا درباره آن پیشبینی انجام میدهند. اما اگر از یک ابزار بخواهید برای شخصیت بازی شما تصویر بسازد، داستانی بنویسد یا قطعه کدی پیشنهاد دهد، وارد بخش دیگری از AI شدهاید.
هوش مصنوعی مولد (Generative Artificial Intelligence یا Generative AI) به مدلهایی گفته میشود که میتوانند محتوایی مانند متن، تصویر، صدا، ویدئو یا کد تولید کنند.
این مدلها محتوا را از هیچ نمیسازند. آنها ساختارها و الگوهای موجود در دادههای آموزشی را یاد میگیرند و براساس آنها خروجی تازهای تولید میکنند. تازه بودن خروجی به معنای داشتن احساس، تجربه شخصی یا قصد خلاقانه نیست.
بسیاری از ابزارهای مولد بر مدلهای پایه (Foundation Models) تکیه دارند. مدل پایه با دادههای گسترده آموزش میبیند و بعد میتواند برای چند کار مختلف استفاده یا برای وظیفهای مشخص تنظیم شود. مدلهای زبانی بزرگ از نمونههای شناختهشده این گروهاند.
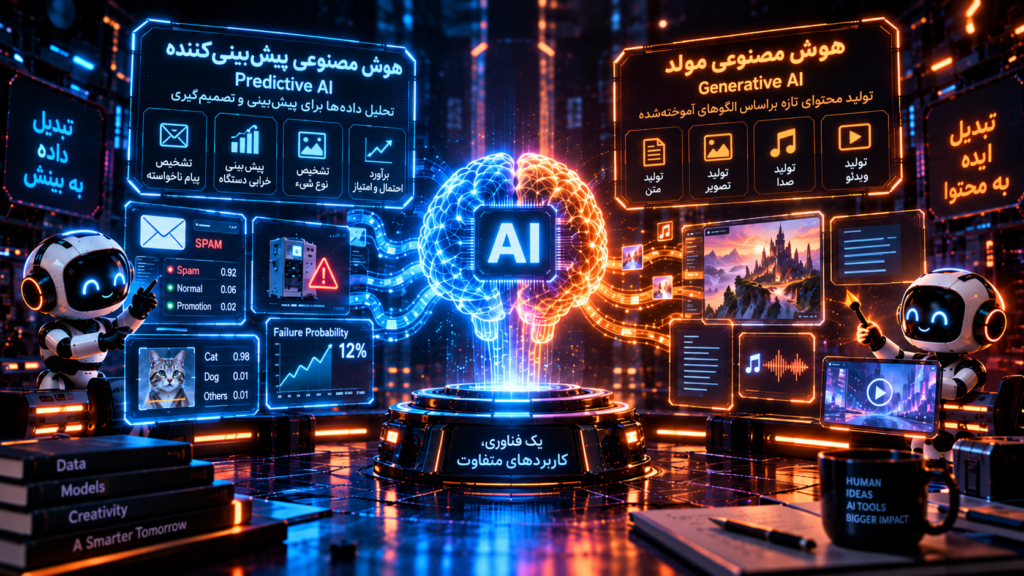
تفاوت هوش مصنوعی پیشبینیکننده و مولد
هوش مصنوعی پیشبینیکننده (Predictive AI) معمولاً یک برچسب، امتیاز، احتمال یا پیشبینی تولید میکند. تشخیص پیام ناخواسته، پیشبینی خرابی دستگاه یا مشخص کردن نوع شیء در تصویر نمونههایی از آن هستند.
هوش مصنوعی مولد، محتوایی مانند متن یا تصویر میسازد. برای مثال، بهجای تشخیص موضوع یک داستان، میتواند پیشنویس داستان تازهای تولید کند.
مرز این دو کاملاً جدا نیست. مدل مولد نیز هنگام ساخت محتوا از پیشبینی استفاده میکند. همچنین یک محصول میتواند چند مدل پیشبینیکننده و مولد را کنار هم قرار دهد.
مدل زبانی بزرگ چگونه پاسخ میسازد؟
مدل زبانی بزرگ (Large Language Model یا LLM) نوعی مدل است که برای پردازش و تولید زبان آموزش میبیند. بسیاری از مدلهای زبانی جدید از معماری ترنسفورمر (Transformer) استفاده میکنند.
وقتی جملهای برای مدل میفرستید، مدل آن را دقیقاً به همان شکلی که روی صفحه میبینید پردازش نمیکند. ابتدا متن به واحدهای کوچکتری به نام توکن (Token) تقسیم میشود. یک توکن میتواند یک واژه، بخشی از واژه، عدد یا نشانه باشد.
سپس توکنها به نمایشهای عددی تبدیل میشوند. مدل با سازوکاری به نام توجه (Attention) بررسی میکند کدام قسمتهای ورودی برای پردازش بخش فعلی اهمیت بیشتری دارند. در ادامه، احتمال گزینههای مختلف برای توکن بعدی را محاسبه و یکی از آنها را انتخاب میکند. این فرایند بارها تکرار میشود تا پاسخ کامل شود.
فرض کنید جمله با این عبارت شروع شده است: «برای خیس نشدن زیر باران، بهتر است…» مدل براساس الگوهای آموختهشده تشخیص میدهد عبارتی مانند «چتر همراه داشته باشید» در این موقعیت محتملتر از یک ادامه نامرتبط است.
مدل معمولاً یک پاسخ آماده و ثابت را از حافظه بیرون نمیآورد؛ خروجی را مرحلهبهمرحله میسازد. البته ممکن است در بعضی شرایط بخشهایی از دادههای آموزشی را بازتولید کند. به همین دلیل کیفیت داده، حریم خصوصی و حقوق آثار در آموزش و استفاده از مدلها اهمیت دارند.
هوش مصنوعی چگونه تصویر میسازد؟
همه مدلهای مولد، مدل زبانی نیستند. بسیاری از ابزارهای تولید تصویر از مدلهای انتشار (Diffusion Models) استفاده میکنند.
در توضیحی ساده، این مدلها در زمان آموزش یاد میگیرند چگونه نویز را از تصویر تشخیص دهند و کاهش دهند. هنگام تولید تصویر، فرایند از الگویی شبیه نویز آغاز میشود و مدل در چند مرحله آن را براساس درخواست متنی به تصویر نزدیک میکند.
این توضیح، شکل سادهشده فرایند است. مدل تصویر را مانند یک نقاش انسانی تصور نمیکند و تصمیم هنری آگاهانه ندارد؛ با استفاده از الگوهای عددی آموختهشده، خروجی را مرحلهبهمرحله شکل میدهد.
پرامپت چیست و چرا اهمیت دارد؟
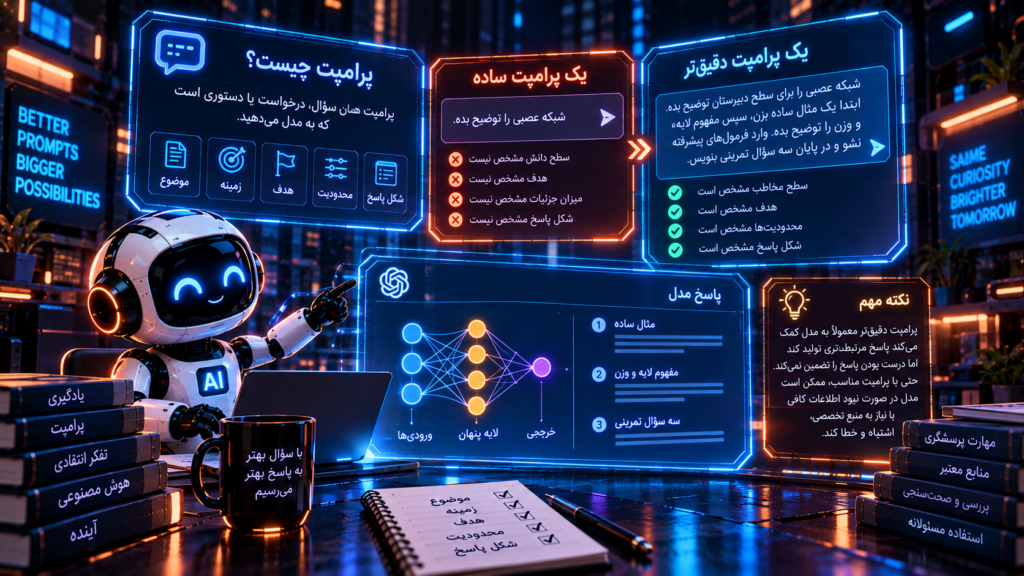
پرامپت (Prompt) همان سؤال، درخواست یا دستوری است که به مدل میدهید. پرامپت میتواند موضوع، زمینه، هدف، محدودیت و شکل پاسخ مورد انتظار را مشخص کند.
اگر فقط بنویسید «شبکه عصبی را توضیح بده»، مدل نمیداند سطح دانش شما چقدر است، توضیح را برای چه کاری میخواهید یا چه میزان جزئیات برایتان مناسب است.
میتوانید درخواست دقیقتری بنویسید:
شبکه عصبی را برای سطح دبیرستان توضیح بده. ابتدا یک مثال ساده بزن، سپس مفهوم لایه و وزن را توضیح بده. وارد فرمولهای پیشرفته نشو و در پایان سه سؤال تمرینی بنویس.
پرامپت دقیقتر معمولاً به مدل کمک میکند پاسخ مرتبطتری تولید کند اما درست بودن پاسخ را تضمین نمیکند. اگر مدل اطلاعات کافی نداشته باشد یا مسئله به منبع تخصصی نیاز داشته باشد، ممکن است با وجود پرامپت مناسب، همچنان اشتباه و خطا کند.
مدل زبانی، چتبات و ChatGPT چه تفاوتی دارند؟
مدل زبانی (Language Model) فناوریای برای پردازش و تولید زبان است. چتبات (Chatbot) برنامه یا رابطی است که امکان گفتوگو با کاربر را فراهم میکند.
بعضی چتباتهای قدیمی فقط پاسخهای از پیش تعیینشده داشتند. بسیاری از چتباتهای جدید به مدلهای زبانی متصلاند و میتوانند پاسخهای تازه تولید کنند.
ابزار ChatGPT نام یک محصول مشخص مبتنی بر هوش مصنوعی است؛ نه نام عمومی همه چتباتها و نه مترادف هوش مصنوعی.
یک محصول گفتوگومحور ممکن است علاوه بر مدل زبانی، به موتور جستوجو، ابزار تحلیل تصویر، تولید صدا یا نرمافزارهای دیگر متصل باشد. به همین دلیل، چیزی که شما در یک محصول میبینید معمولاً فقط یک مدل خام نیست، بلکه مجموعهای از چند سیستم است.
مدل زبانی چه تفاوتی با موتور جستوجو دارد؟
موتور جستوجو معمولاً صفحهها و اسناد موجود را پیدا و مرتب میکند. مدل زبانی براساس الگوهای آموختهشده پاسخ میسازد. این دو کار یکسان نیستند.
بعضی سامانهها این دو قابلیت را با روشی به نام تولید تقویتشده با بازیابی (Retrieval-Augmented Generation یا RAG) ترکیب میکنند. سیستم ابتدا اطلاعات مرتبط را از منبعی بیرونی پیدا میکند و سپس مدل با استفاده از آنها پاسخ میدهد.
این روش میتواند پاسخ را مستندتر یا بهروزتر کند، اما احتمال خطا را از بین نمیبرد. ممکن است منبع نامناسب انتخاب شود، بخشی از آن اشتباه تفسیر شود یا مدل نتیجهای فراتر از اطلاعات موجود بسازد.
کاربردهای هوش مصنوعی در زندگی، تحصیل و صنعت
حالا که میدانیم هوش مصنوعی چگونه کار میکند، میتوانیم رد آن را در زندگی روزمره دنبال کنیم. وقتی گوشی صدای شما را به متن تبدیل میکند، وقتی برنامه مسیریابی زمان رسیدن را تخمین میزند یا وقتی یک فروشگاه اینترنتی محصولی را پیشنهاد میدهد، ممکن است یک یا چند مدل AI در پسزمینه فعال باشند.
در این کاربردها، هدف یکسان نیست. مدل مسیریابی تلاش میکند زمان یا مسیر را پیشبینی کند، سیستم پیشنهاددهنده گزینهها را مرتب میکند و ابزار مولد محتوایی تازه میسازد.
نکته مهم این است که مناسب بودن یک مدل به کاربرد آن بستگی دارد. اگر یک پلتفرم فیلم نامناسبی پیشنهاد دهد، احتمالاً فقط آن را نادیده میگیرید اما خطای یک سیستم پزشکی یا حملونقل ممکن است پیامد جدیتری داشته باشد.
هوش مصنوعی برای یادگیری و درس خواندن
فرض کنید فردا امتحان دارید و از یک چتبات میخواهید یک یا چند فصل از کتاب را خلاصه کند. چند ثانیه بعد، متنی مرتب تحویل میگیرید. این روش سریع است اما خواندن یک خلاصه آماده لزوماً به معنای یاد گرفتن درس نیست. ممکن است نکتهای مهم حذف شده یا بخشی از پاسخ اشتباه باشد.
حالا مسیر دیگری را تصور کنید. ابتدا فصل را میخوانید، سپس از مدل میخواهید پنج سوال مفهومی بسازد. پاسخها را خودتان مینویسید و از ابزار میخواهید فقط ایراد استدلالتان را توضیح دهد. در این حالت، AI به یادگیری کمک میکند اما فکر کردن را از شما نمیگیرد.
میتوانید از هوش مصنوعی برای سادهسازی یک مفهوم سخت و پیچیده، ساخت سوال تمرینی، مقایسه چند روش حل مسئله، تمرین زبان، دریافت بازخورد اولیه درباره نوشته یا پیدا کردن خطای احتمالی کد کمک بگیرید.
نوع درخواست شما اهمیت زیادی دارد. بهجای اینکه بنویسید «جواب این مسئله را بده»، میتوانید بنویسید:
پاسخ نهایی را ننویس. ابتدا مفهوم لازم را توضیح بده، سپس یک راهنمای مرحلهای ارائه کن و در پایان مسئلهای مشابه برای تمرین بساز.
هوش مصنوعی در سلامت، کشاورزی و صنعت
کاربرد AI با گوشی و کلاس درس تمام نمیشود. در حوزهی سلامت، مدلها میتوانند به تحلیل برخی تصاویر و پیدا کردن الگو در دادهها کمک کنند. این کاربرد به معنای کنار گذاشتن پزشک نیست؛ خروجی سیستم باید براساس کاربرد، با نظارت متخصص و ارزیابی دقیق استفاده شود.
در کشاورزی، تحلیل تصاویر گیاهان یا دادههای حسگرها میتواند به پایش مزرعه کمک کند. اما مدلی که با دادههای یک منطقه آموزش دیده، ممکن است در شرایط آبوهوایی یا خاک متفاوت همان عملکرد را نداشته باشد.
در کارخانههای صنعتی، مدل میتواند نشانههای خرابی احتمالی را در دادههای دستگاهها پیدا کند. اگر حسگر درست کار نکند یا داده ناقص باشد، نتیجه مدل نیز ممکن است اشتباه شود.
در امنیت سایبری، AI میتواند برای شناسایی رفتار غیرعادی و اولویتبندی هشدارها به کار رود. در مقابل، افراد مهاجم نیز ممکن است از ابزارهای مولد برای ساخت پیامهای فریبنده یا جعل هویت استفاده کنند.
در بازیسازی، AI میتواند در یافتن مسیر، کنترل بعضی رفتارهای شخصیتها، آزمایش بازی و تولید برخی محتواهای اولیه کاربرد داشته باشد. کیفیت خروجی، هماهنگی با طراحی بازی و حقوق آثار همچنان باید بررسی شوند.
پس سؤال درست فقط این نیست که «آیا در این کار از AI استفاده شده است؟» بهتر است بپرسیم سیستم دقیقاً چه نقشی دارد، با چه دادهای کار میکند، چگونه ارزیابی شده و اگر اشتباه کند چه اتفاقی میافتد.
مزایا و معایب هوش مصنوعی
هوش مصنوعی میتواند تعداد زیادی نمونه را در زمان کوتاه بررسی کند، الگوهایی را پیدا کند که در بررسی دستی بهسختی دیده میشوند و برای بعضی کارها پیشنویس یا پیشنهاد اولیه بسازد.
این تواناییها در تحلیل داده، تشخیص خطا، دسترسپذیری ابزارها، پژوهش و انجام بعضی کارهای تکراری مفیدند. برای مثال، تبدیل گفتار به متن میتواند دسترسی به محتوا را آسانتر کند و تحلیل خودکار دادهها میتواند سرنخهایی برای بررسی پژوهشگر فراهم کند.
اما استفاده از AI بهخودیِخود یک فرایند را بهتر نمیکند. اگر مسئله درست تعریف نشده باشد یا داده کیفیت مناسبی نداشته باشد، سیستم میتواند خطا را با سرعت بیشتری گسترش دهد.
میتوان سرعت هوش مصنوعی را یک تقویتکننده دانست: اگر مسیر درست باشد، کار را سریعتر پیش میبرد؛ اگر مسیر اشتباه باشد، شما را سریعتر از مقصد دور میکند.
چرا هوش مصنوعی اشتباه میکند؟
خطای هوش مصنوعی معمولاً یک علت واحد ندارد. ممکن است دادهها ناقص، قدیمی یا اشتباه باشند. گاهی شرایط واقعی با نمونههایی که مدل هنگام آموزش دیده تفاوت دارد. بعضی ورودیها نیز مبهماند و مدل زمینه کافی برای تشخیص منظور درست ندارد.
هدف تعیینشده برای مدل نیز مهم است. سیستم همان چیزی را بهتر میکند که برایش تعریف شده است. اگر معیار انتخابشده با هدف واقعی هماهنگ نباشد، ممکن است مدل از نظر عددی نتیجه خوبی بگیرد اما در عمل مفید نباشد.
دوباره به مثال فیلتر هرزنامه برگردیم. فرض کنید این مدل بیشتر پیامها را درست تشخیص میدهد اما تعدادی از پیامهای سالم و مهم را نیز حذف میکند. یک عدد کلی درباره عملکرد مدل، این مشکل را کامل نشان نمیدهد. باید بررسی کنیم که مدل چه اشتباهی انجام داده و هر اشتباه چه پیامدی دارد.
همچنین ممکن است الگوی دادهها با گذشت زمان تغییر کند. به این اتفاق رانش داده (Data Drift) گفته میشود. برای مثال، فرستندگان پیامهای ناخواسته میتوانند شیوه نوشتن خود را تغییر دهند و از عبارتهای تازهای استفاده کنند. در این حالت، مدل قدیمی ممکن است بخشی از پیامهای جدید را تشخیص ندهد.
توهم هوش مصنوعی چیست؟
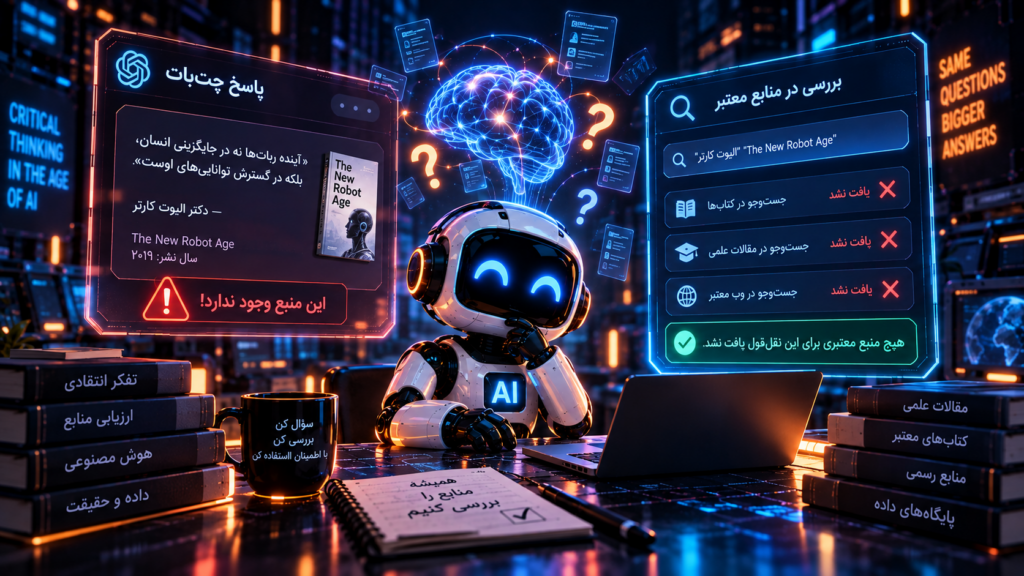
فرض کنید از یک چتبات میخواهید جملهای از یک دانشمند درباره رباتها پیدا کند. مدل جملهای حرفهای همراه با نام کتاب و سال انتشار مینویسد. وقتی موضوع را بررسی میکنید، متوجه میشوید آن جمله یا حتی کتاب معرفیشده وجود ندارد.
به تولید اطلاعات ظاهراً قابل قبول اما نادرست، توهم هوش مصنوعی (AI Hallucination) یا جعل واقعیت (Confabulation) گفته میشود.
مدل زبانی یاد گرفته است واژهها را براساس الگوهای زبانی کنار هم قرار دهد اما نمیتواند درستی همه اطلاعاتی را که تولید میکند تضمین کند. به همین دلیل ممکن است منبعی غیرواقعی معرفی کند، نقلقولی بسازد، تاریخ را اشتباه بنویسد یا چند رویداد واقعی را با هم ترکیب کند.
درخواست منبع از مدل مفید است اما کافی نیست؛ زیرا خود منبع هم ممکن است ساختگی یا نامرتبط باشد. تاریخها، آمارها، نامها و نقلقولها را باید در منبع معتبر و ترجیحاً اولیه بررسی کنید. این موضوع درباره اطلاعات پزشکی، حقوقی و مالی اهمیت بیشتری دارد.
سوگیری چگونه وارد مدل میشود؟
سوگیری (Bias) میتواند از داده ورودی، شیوه برچسبگذاری، تصمیمهای طراحی یا استفاده از مدل در موقعیتی نامناسب شکل بگیرد.
فرض کنید یک سامانه تشخیص گفتار بیشتر با صدای گروه محدودی از افراد آموزش دیده باشد. ممکن است هنگام شنیدن لهجهها، گروههای سنی یا شرایط ضبط متفاوت عملکرد یکسانی نداشته باشد. مسئله لزوماً از کاربر نیست؛ شاید داده آموزشی تنوع کافی نداشته است.
دادههای گذشته نیز میتوانند نابرابریهای موجود در جامعه را بازتاب دهند. اگر مدل این الگوها را بدون ارزیابی یاد بگیرد، ممکن است آنها را در خروجی خود تکرار کند.
انتخاب داده مناسب، آزمایش مدل برای گروههای مختلف، شفافیت و نظارت انسانی میتوانند خطر سوگیری را کاهش دهند. با این حال، عدالت معیار ساده و یکسانی برای همه کاربردها نیست و باید براساس موقعیت بررسی شود.
حریم خصوصی در هوش مصنوعی؛ چه اطلاعاتی را نباید وارد AI کنیم؟
وقتی متنی را در یک ابزار هوش مصنوعی وارد میکنید، نباید از قبل فرض کنید که اطلاعاتتان خصوصی باقی میماند. نحوه ذخیره و استفاده از داده به تنظیمات و سیاست همان سرویس بستگی دارد.
پیش از ارسال اطلاعات باید بدانید چه دادهای ذخیره میشود، چه مدت باقی میماند، چه کسانی به آن دسترسی دارند و آیا برای بهبود محصول استفاده میشود یا خیر.
یادتان باشد که هرگز رمز عبور، اطلاعات هویتی، پرونده شخصی، فایل محرمانه یا تصویر دیگران را بدون اجازه وارد ابزارهای هوش مصنوعی نکنید. حذف نام نیز همیشه اطلاعات را کاملاً ناشناس نمیکند چرا که ممکن است ترکیب جزئیات دیگر هویت فرد را آشکار کند.
جعل عمیق یا دیپ فیک؛ آیا هرچه میبینیم واقعی است؟
ویدئویی منتشر میشود که در آن فردی شناختهشده جملهای عجیب بیان میکند. تصویر طبیعی است، حرکت لبها با صدا هماهنگ به نظر میرسد و کیفیت ویدئو هم بالاست. آیا همین نشانهها برای واقعی دانستن آن کافیاند؟
خیر. جعل عمیق (Deepfake) تصویر، صدا یا ویدئویی است که با هوش مصنوعی تولید یا دستکاری شده و میتواند واقعی به نظر برسد.
با پیشرفت ابزارهای مولد، صرفاً دیدن یک عکس یا شنیدن یک صدا برای اثبات اصالت آن کافی نیست. موارد مهمتر دیگری مانند منبع انتشار، نسخه اصلی، زمان، زمینه و تأیید منابع مستقل هم باید بررسی شوند.
بعضی نشانههای ظاهری مانند حرکت غیرطبیعی یا خطای تصویری میتوانند کمککننده باشند اما همیشه قابل اعتماد نیستند. ابزارهای تولید محتوا تغییر میکنند و ممکن است یک فایل جعلی هیچ ایراد آشکاری نداشته باشد.
آیا هوش مصنوعی احساس و آگاهی دارد؟
یک چتبات ممکن است بنویسد «خوشحالم که کمکت کردم» یا «احساس شما را درک میکنم». این جملهها به هیچوجه ثابت نمیکنند که مدل احساس یا تجربه درونی دارد.
مدل زبانی از الگوهای زبان استفاده میکند و میتواند پاسخهایی شبیه گفتوگوی انسانی بسازد. نسبت دادن ویژگیهای انسانی به ماشین، انسانانگاری (Anthropomorphism) نام دارد.
شاید برایتان جالب باشد که بدانید، اینکه آیا ساختن ماشین آگاه در آینده ممکن است یا خیر، پرسشی باز در علم و فلسفه است اما توانایی مدلهای فعلی در گفتوگوی روان نباید معادل آگاهی، نیت، صداقت یا فهم انسانی در نظر گرفته شود.
چگونه مسئولانه از هوش مصنوعی استفاده کنیم؟
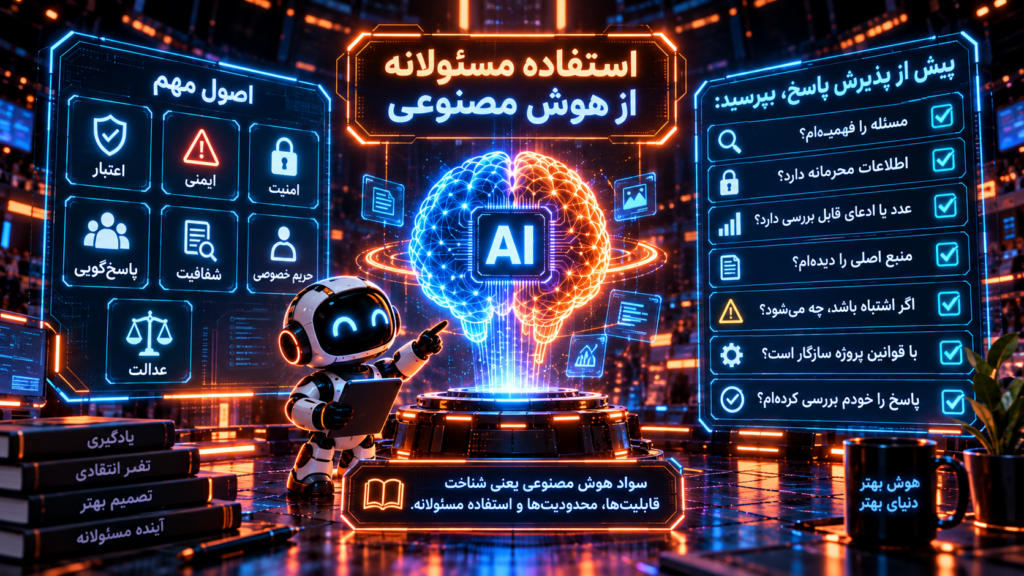
مؤسسه ملی استاندارد و فناوری آمریکا (National Institute of Standards and Technology یا NIST) در چارچوبهای خود برای هوش مصنوعی قابل اعتماد، بر ویژگیهایی مانند اعتبار، ایمنی، امنیت، پاسخگویی، شفافیت، حفاظت از حریم خصوصی و توجه به عدالت تأکید میکند.
این مفاهیم شاید در نگاه اول مربوط به شرکتهای بزرگ به نظر برسند اما هنگام استفاده روزمره نیز کاربرد دارند. پیش از پذیرفتن خروجی AI، چند سوال ساده از خودتان بپرسید:
- آیا خودم مسئله را فهمیدهام؟
- آیا اطلاعات شخصی یا محرمانهای در ورودی وجود دارد؟
- آیا پاسخ شامل عدد، تاریخ، نقلقول یا ادعایی قابل بررسی است؟
- آیا منبع اصلی ادعا را دیدهام؟
- اگر پاسخ اشتباه باشد، چه پیامدی ایجاد میشود؟
- آیا استفاده از ابزار با قوانین کلاس، مسابقه یا پروژه سازگار است؟
- آیا متن نهایی را خودم بررسی و اصلاح کردهام؟
سواد هوش مصنوعی (AI Literacy) فقط به معنای بلد بودن چند ابزار یا نوشتن پرامپت نیست. باید بتوانید قابلیتها و محدودیتهای سیستم را بشناسید، خروجی آن را منتقدانه بررسی کنید و درباره شیوه استفاده از آن تصمیم مسئولانه بگیرید.
تاریخچه هوش مصنوعی؛ داستانی قدیمیتر از ChatGPT
داستان توسعه هوش مصنوعی با چتباتهای جدید آغاز نشده و به سالها قبل بازمیگردد. ریشههای آن را باید در منطق، ریاضیات، آمار، علوم شناختی و شکلگیری رایانه جستوجو کرد.
در سال ۱۹۵۰، آلن تورینگ (Alan Turing)، ریاضیدان انگلیسی که به پدر علوم کامپیوتر و هوش مصنوعی معروف است، مقالهی «ماشینهای محاسباتی و هوش» را با یک پرسش مهم آغاز کرد: «آیا ماشینها میتوانند فکر کنند؟»
از آنجا که تعریف «فکر کردن» آسان نبود، تورینگ یک بازی گفتوگومحور را بررسی کرد که بعدها به آزمون تورینگ (Turing Test) معروف شد. در شکل ساده این ایده، اگر ارزیاب نتواند در گفتوگو انسان را از ماشین تشخیص دهد، ماشین توانسته رفتاری انسانمانند نشان دهد.
آزمون تورینگ تمام جنبههای هوش را اندازه نمیگیرد. یک سیستم ممکن است در گفتوگویی کوتاه انسانمانند به نظر برسد اما در استدلال یا شناخت جهان محدود باشد. با این حال، پرسش تورینگ نقش مهمی در گسترش بحث علمی درباره هوش ماشین داشت.
چند سال بعد، دانشمندانی مانند جان مککارتی (John McCarthy)، ماروین مینسکی (Marvin Minsky)، ناتانیل روچستر (Nathaniel Rochester) و کلود شانون (Claude Shannon) پیشنهاد برگزاری یک مطالعه تابستانی در کالج دارتموث را آماده کردند. این برنامه در تابستان ۱۹۵۶ برگزار شد و اصطلاح «هوش مصنوعی» را بهعنوان نام یک رشته پژوهشی تثبیت کرد.
پژوهشهای اولیه بیشتر بر منطق، بازی، حل مسئله و روشهای نمادین متمرکز بودند. پژوهشگران امیدوار بودند بتوانند بخشهایی از استدلال انسان را به قواعدی تبدیل کنند که رایانه قادر به اجرای آنها باشد.
پس از آن سیستمهای خبره شکل گرفتند و تلاش کردند دانش متخصصان را به مجموعهای از قواعد رایانهای تبدیل کنند. این روش در مسائل مشخص مفید بود اما ثبت و بهروزرسانی دستی تعداد زیادی قاعده کار سادهای نبود. سیستمها نیز در برخورد با موقعیتهایی که برایشان قاعدهای نوشته نشده بود، انعطاف کمی داشتند.
در دورههایی، انتظارها از AI بیشتر از توان فناوری آن زمان شد. وقتی بعضی وعدهها محقق نشدند، سرمایهگذاری و توجه پژوهشی کاهش یافت. این دورهها معمولاً زمستان هوش مصنوعی (AI Winter) نامیده میشوند.
علیرغم وجود زمستان هوش مصنوعی، پژوهشها متوقف نشد. با افزایش دادههای دیجیتال، توان پردازشی و پیشرفت الگوریتمها، یادگیری ماشین و شبکههای عصبی دوباره مورد توجه قرار گرفتند. بهجای نوشتن همه قواعد با دست، پژوهشگران بیش از گذشته به مدلهایی روی آوردند که میتوانستند الگوها را از داده یاد بگیرند.
در سال ۲۰۱۲، مدل AlexNet در رقابت تشخیص تصویر ImageNet عملکرد تأثیرگذاری نشان داد و توجه بیشتری را به یادگیری عمیق جلب کرد. ترکیب شبکه عصبی عمیق، داده مناسب و پردازندههای گرافیکی نقش مهمی در این نتیجه داشت.
در سال ۲۰۱۷، معماری ترنسفورمر در مقاله «Attention Is All You Need» معرفی شد. این معماری ابتدا برای پردازش توالی و ترجمه ماشینی ارائه شد و بعدتر به یکی از پایههای فنی بسیاری از مدلهای زبانی بزرگ تبدیل شد.
از سال ۲۰۲۲، دسترسی عمومیتر به چتباتها و ابزارهای مولد باعث شد افراد بیشتری تولید متن، تصویر، صدا و کد با AI را تجربه کنند. این اتفاق آغاز هوش مصنوعی نبود؛ نتیجه چند دهه پژوهش در الگوریتم، داده، نرمافزار و سختافزار بود.
وقتی این مسیر را کنار هم میگذاریم، میبینیم هوش مصنوعی با یک جهش ناگهانی به وجود نیامده است. هر مرحله از پیشرفت آن بر ایدهها، موفقیتها و حتی شکستهای مرحلههای قبلی بنا شده است.
آینده هوش مصنوعی و تأثیر آن بر شغلها
بعد از شناخت تاریخچه هوش مصنوعی، پرسش مهم این است که این فناوری در آینده چه تغییری ایجاد میکند. یکی از رایجترین نگرانیها هم به شغلها مربوط میشود: آیا هوش مصنوعی جای انسان را میگیرد؟
برای رسیدن به پاسخ دقیقتر، بهتر است شغل را یک فعالیت واحد نبینیم. هر شغل از چند وظیفه تشکیل شده است. هوش مصنوعی ممکن است بعضی از این وظایف را خودکار کند، انجام بعضی را سریعتر کند و اهمیت برخی مهارتها را افزایش دهد.
برای مثال یک تولیدکننده محتوا را در نظر بگیرید. مدل میتواند چند عنوان یا پیشنویس اولیه پیشنهاد دهد اما شناخت مخاطب، بررسی صحت، انتخاب جهت فکری، گفتوگو با افراد و پذیرش مسئولیت نتیجه همچنان به انسان وابسته است.
در برنامهنویسی نیز AI میتواند یک قطعه کد پیشنهاد دهد یا خطای احتمالی را پیدا کند. با این حال، تعریف مسئله، طراحی ساختار نرمافزار، بررسی امنیت، آزمایش و تصمیمگیری درباره نتیجه حذف نمیشوند.
بررسیهای سازمان بینالمللی کار (International Labour Organization یا ILO) درباره هوش مصنوعی مولد و مشاغل نشان میدهند که در بسیاری از موارد، تغییر وظایف محتملتر از خودکارسازی کامل یک شغل است. میزان اثرپذیری مشاغل نیز براساس نوع حرفه، کشور، قوانین و ساختار اقتصادی تفاوت دارد.
توانایی فنی AI برای انجام یک وظیفه به معنای حذف قطعی آن شغل نیست. هزینه فناوری، کیفیت خروجی، اعتماد کاربران، قوانین، مسئولیت حقوقی و تصمیم سازمانها هم بر نتیجه اثر میگذارند.
از طرف دیگر، نباید تصور کنیم هیچ شغلی تغییر نخواهد کرد. بعضی وظایف تکراری و قابل پیشبینی بیشتر در معرض خودکارسازیاند. در بسیاری از حرفهها، افرادی که بتوانند AI را درست به کار بگیرند و خروجی آن را ارزیابی کنند، شیوه کار متفاوتی خواهند داشت.
درباره بازار کار ایران نیز نباید اطلاعات یک کشور دیگر را مستقیماً به ایران تعمیم داد. برای پیشبینی دقیق به دادههای معتبر و بهروز درباره ساختار مشاغل، میزان استفاده سازمانها و شرایط اقتصادی ایران نیاز داریم. بدون چنین دادهای، وعده درآمد یا تضمین آینده شغلی قابل دفاع نیست.
در کنار AI چه مهارتهایی مهمتر میشوند؟
ابزارها و فناوری هوش مصنوعی هر روز درحال پیشرفت هستند و تغییر میکنند. اگر تمامی مهارت شما به کار کردن با یک محصول خاص محدود باشد، با تغییر آن محصول ناگزیر بخشی از تواناییتان را از دست میدهید. یادتان بماند که مهارتهای بنیادی ماندگارترند.
تعریف مسئله یکی از این مهارتهاست. باید بتوانید یک موقعیت مبهم را به سؤالهایی دقیق تبدیل کنید. مدلی که بهترین پاسخ را تولید میکند هم نمیتواند یک سؤال نامشخص را همیشه درست تفسیر کند.
تفکر انتقادی کمک میکند که پاسخ روان را با پاسخ معتبر اشتباه نگیرید. باید بتوانید تناقضها را پیدا کنید، شواهد را بررسی کنید و درباره قابل اعتماد بودن نتیجه تصمیم بگیرید.
سواد داده (Data Literacy) نیز اهمیت زیادی دارد. لازم است که بدانید داده از کجا آمده، چه محدودیتهایی دارد و آیا برای نتیجهگیری شما مناسب است.
برنامهنویسی، ریاضی و آمار برای ساخت و ارزیابی سیستمها مفیدند. در کنار آنها، دانش تخصصی، ارتباط، همکاری و مسئولیتپذیری هم اهمیت دارند. بدون شناخت موضوع، حتی بهترین ابزار نیز نمیتواند کیفیت نتیجه را تضمین کند.
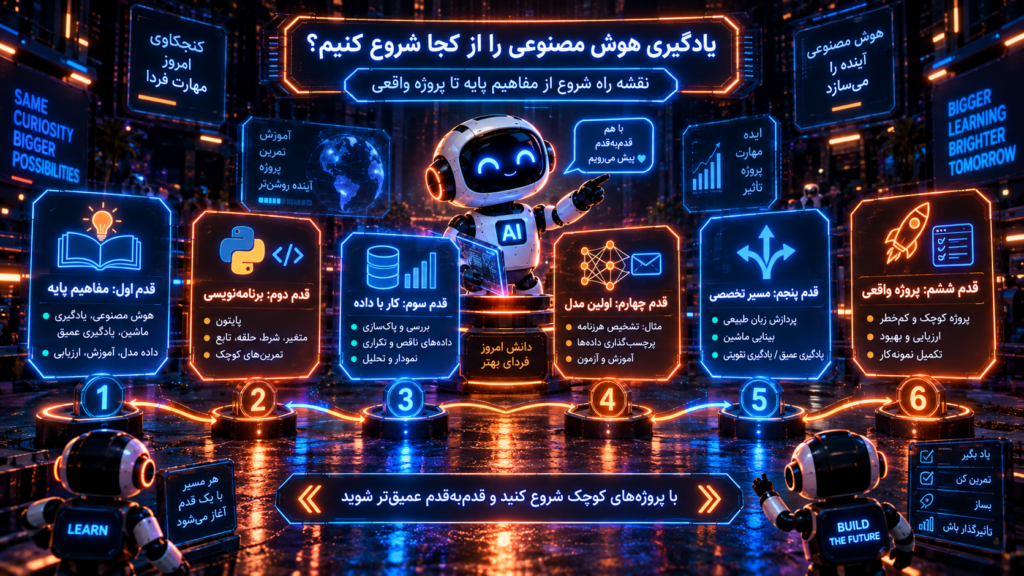
یادگیری هوش مصنوعی را از کجا شروع کنیم؟
برای استفاده مقدماتی از ابزارهای AI الزاماً نیازی به برنامهنویسی پیشرفته ندارید اما اگر میخواهید بفهمید مدلها چگونه ساخته میشوند یا پروژه خودتان را توسعه دهید، باید بهتدریج مهارتهایی مانند برنامهنویسی، داده و ریاضی را یاد بگیرید.
لازم نیست پیش از شروع در تمام این مباحث متخصص باشید. میتوانید همزمان با انجام پروژههای کوچک، دانشِ مورد نیازتان را کامل کنید.
قدم اول: مفاهیم پایه را بفهمید
ابتدا تفاوت هوش مصنوعی، یادگیری ماشین، یادگیری عمیق و هوش مصنوعی مولد را یاد بگیرید. باید بدانید داده چیست، مدل چگونه آموزش میبیند و چرا آزمایش روی داده تازه اهمیت دارد.
هدف، حفظ کردن اصطلاحات نیست. تلاش کنید هر مفهوم را با یک مثال مانند تشخیص هرزنامه، پیشنهاد فیلم یا شناسایی تصویر برای خودتان توضیح دهید. اگر توانستید یک مفهوم را با زبان ساده برای دوستتان تعریف کنید، احتمالاً آن را بهتر فهمیدهاید.
قدم دوم: برنامهنویسی را شروع کنید
زبان پایتون (Python) یکی از زبانهای پرکاربرد در یادگیری ماشین است. ابتدا با متغیر، شرط، حلقه، تابع و ساختارهای داده آشنا شوید.
پیش از ورود به مدلهای پیچیده، چند برنامه کوچک بنویسید که داده دریافت کنند، آن را پردازش کنند و نتیجه را نمایش دهند. همین تمرینهای ساده، پایه حل مسئله را قویتر میکنند.
قدم سوم: کار با داده را یاد بگیرید
دادههای واقعی همیشه مرتب و آماده نیستند. ممکن است بعضی مقدارها ناقص، اشتباه یا تکراری باشند. باید یاد بگیرید داده را بررسی، پاکسازی و با نمودار نمایش دهید.
در بسیاری از پروژهها، شناخت و آمادهسازی داده بخش مهمی از کار است. انتخاب مدلی پیچیده نمیتواند ضعفهای جدی داده را خودکار جبران کند.
قدم چهارم: اولین مدل را بسازید
با مسئلهای ساده شروع کنید؛ مثلاً مدلی بسازید که پیامها را به دو گروه سالم و ناخواسته تقسیم کند.
در این پروژه، همان مسیری را طی میکنید که از ابتدای مقاله دنبال کردیم: پیامها را جمعآوری میکنید، برایشان برچسب میگذارید، بخشی را برای آموزش کنار میگذارید و در پایان، مدل را با پیامهایی میسنجید که قبلاً ندیده است.
بعد از ساخت مدل، فقط به درصد کلی پاسخهای درست نگاه نکنید. بررسی کنید چند پیام سالم بهاشتباه حذف شدهاند و مدل چند پیام مشکوک را تشخیص نداده است. اینجا متوجه میشوید که ارزیابیِ مدل، بخشی از ساخت آن است، نه کاری اضافی در پایان پروژه.
قدم پنجم: وارد مسیر تخصصیتر شوید
پس از یادگیری مبانی، میتوانید براساس علاقهتان یکی از مسیرهای پردازش زبان طبیعی، بینایی ماشین، یادگیری عمیق یا یادگیری تقویتی را دنبال کنید.
اگر به متن و زبان علاقه دارید، میتوانید روی دستهبندی متن یا تحلیل زبان کار کنید. اگر از تصویر و ویدئو لذت میبرید، پروژههای بینایی ماشین انتخاب مناسبی هستند. اگر بازی و تصمیمگیری برایتان جذاب است، یادگیری تقویتی میتواند مسیر متفاوتی پیش رویتان بگذارد.
لازم نیست همه شاخهها را همزمان یاد بگیرید. شناخت کلی آنها کافی است تا بعد بتوانید یک مسیر را عمیقتر دنبال کنید.
قدم ششم: یک پروژه واقعی را کامل کنید
پروژه اول بهتر است کوچک، قابل اندازهگیری و کمخطر باشد. تشخیص پیام ناخواسته، دستهبندی تصاویر ساده، پیشنهاد کتاب براساس چند ویژگی یا ساخت یک عامل برای بازی ساده میتوانند گزینههای مناسبی باشند.
پیش از شروع، از خودتان بپرسید:
- مسئله دقیقاً چیست؟
- داده را از کجا تهیه میکنید؟
- آیا اجازه استفاده از آن را دارید؟
- پاسخ درست چگونه مشخص میشود؟
- مدل را با چه معیاری میسنجید؟
- در چه شرایطی ممکن است شکست بخورد؟
- خطای آن چه پیامدی دارد؟
هدف اولین پروژه، ساخت بزرگترین یا پیچیدهترین مدل نیست. مهم این است که مسیر کامل مسئله، داده، آموزش، آزمون و اصلاح را تجربه کنید.
در رشته هوش مصنوعی رویداد ملی کیبُرد نیز شناخت مفاهیم زمانی به مهارت تبدیل میشود که آموختههایتان را برای ساخت و ارزیابی یک پروژه واقعی به کار بگیرید. این مسیر از یک سؤال ساده شروع میشود و با آزمودن، خطا کردن و بهتر ساختن ادامه پیدا میکند.
جمعبندی
ما این مقاله را با یک پیام مشکوک شروع کردیم؛ پیامی که یک سیستم توانسته بود آن را پیش از شما بهعنوان هرزنامه تشخیص دهد. حالا میدانیم پشت این تصمیم، ذهنخوانی یا جادو قرار نداشت. دادههایی وجود داشتند، الگوریتمی برای یادگیری به کار رفته بود و مدلی آموزش دیده بود تا درباره پیام تازه پیشبینی کند.
هوش مصنوعی نام یک ربات، چتبات یا نرمافزار مشخص نیست. این رشته مجموعهای از روشها برای ساخت سیستمهایی است که ورودی میگیرند، الگوها را بررسی میکنند و خروجیهایی مانند پیشبینی، پیشنهاد، تصمیم یا محتوا میسازند.
یادگیری ماشین یکی از روشهای ساخت AI است و یادگیری عمیق زیرمجموعه آن قرار میگیرد. هوش مصنوعی مولد نیز از الگوهای آموختهشده برای تولید متن، تصویر، صدا، ویدئو یا کد استفاده میکند.
این مدلها میتوانند در وظایف مشخص بسیار توانمند باشند اما ممکن است اطلاعات نادرست تولید کنند، از دادههای نامناسب تأثیر بگیرند یا در موقعیتی تازه عملکرد ضعیفی داشته باشند. به همین دلیل، استفاده درست از AI به کنجکاوی، دانش موضوعی، تفکر انتقادی و بررسی نتیجه نیاز دارد.
شناخت واقعی هوش مصنوعی با چند بار استفاده از یک چتبات کامل نمیشود. بهتر است یک مسئله کوچک انتخاب کنید، دادههای آن را بشناسید، مدلی ساده بسازید و نتیجه را آزمایش کنید. این همان نقطهای است که شناخت فناوری به تجربه ساختن تبدیل میشود.
پرسشهای متداول درباره هوش مصنوعی
AI مخفف چیست؟
AI مخفف Artificial Intelligence و معادل انگلیسی «هوش مصنوعی» است. این اصطلاح به فناوریها و روشهایی اشاره دارد که برای کارهایی مانند تشخیص الگو، یادگیری، پیشبینی یا تصمیمگیری طراحی شدهاند.
آیا ChatGPT همان هوش مصنوعی است؟
خیر. ChatGPT یک محصول مبتنی بر مدلهای هوش مصنوعی است. AI مفهوم گستردهتری دارد و یادگیری ماشین، بینایی ماشین، پردازش زبان طبیعی، رباتیک و شاخههای دیگر را نیز شامل میشود.
آیا هر هوش مصنوعی از یادگیری ماشین استفاده میکند؟
خیر. یادگیری ماشین یکی از روشهای ساخت سیستمهای هوش مصنوعی است. سیستمهای قاعدهمحور و بعضی روشهای جستوجو یا برنامهریزی میتوانند بدون یادگیری ماشین نیز در قلمرو AI قرار بگیرند.
آیا هوش مصنوعی از هر گفتوگو فوراً یاد میگیرد؟
لزوماً خیر. مدل معمولاً با پارامترهایی که پیشتر آموزش دیدهاند پاسخ میدهد. اینکه مکالمات بعداً برای بهبود یک محصول استفاده شوند، به تنظیمات و سیاست حفظ حریم خصوصی همان سرویس بستگی دارد.
آیا هوش مصنوعی بدون اینترنت کار میکند؟
بله. بعضی مدلها میتوانند بهصورت محلی (Local) یا روی دستگاه (On-device) اجرا شوند. اینترنت معمولاً برای استفاده از مدلهای ابری، دریافتِ اطلاعاتِ تازه یا دسترسی به توان پردازشی بیشتر لازم است.
آیا هوش مصنوعی میتواند جای انسان را بگیرد؟
هوش مصنوعی میتواند بعضی وظایف را خودکار یا سریعتر کند اما نتیجه در همه مشاغل یکسان نیست. بسیاری از کارها همچنان به دانش تخصصی، قضاوت، مسئولیتپذیری، ارتباط و نظارت انسان نیاز دارند.
آیا برای یادگیری هوش مصنوعی باید ریاضی و برنامهنویسی پیشرفته بلد باشید؟
برای شروع استفاده از ابزارها، خیر. برای ساخت و ارزیابی مدلها باید بهتدریج برنامهنویسی، آمار، احتمال و مفاهیم ریاضی مرتبط را یاد بگیرید. لازم نیست پیش از ساخت اولین پروژه بر همه این مباحث مسلط باشید.