



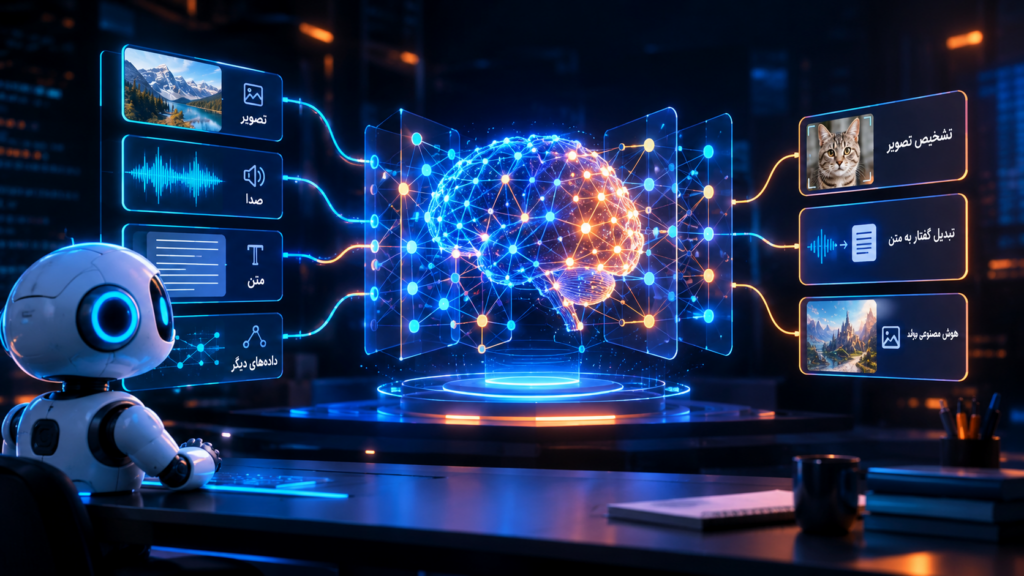
امروزه بسیاری از قابلیتهایی که در ابزارهای هوشمند میبینیم، از تشخیص چهره و تحلیل تصاویر تا تولید متن و تبدیل گفتار به نوشته، به مدلهایی متکی هستند که میتوانند از حجم زیادی از داده، الگو یاد بگیرند. یادگیری عمیق یکی از فناوریهای کلیدی در این مسیر است و با پیشرفت قدرت پردازش و دسترسی به دادههای بیشتر، نقش آن در توسعه سامانههای هوشمند پررنگتر شده است. برای درک نحوه عملکرد این فناوری، ابتدا باید بدانیم یادگیری عمیق دقیقاً چیست و چه تفاوتی با روشهای دیگر یادگیری ماشین دارد.
یادگیری عمیق چیست؟
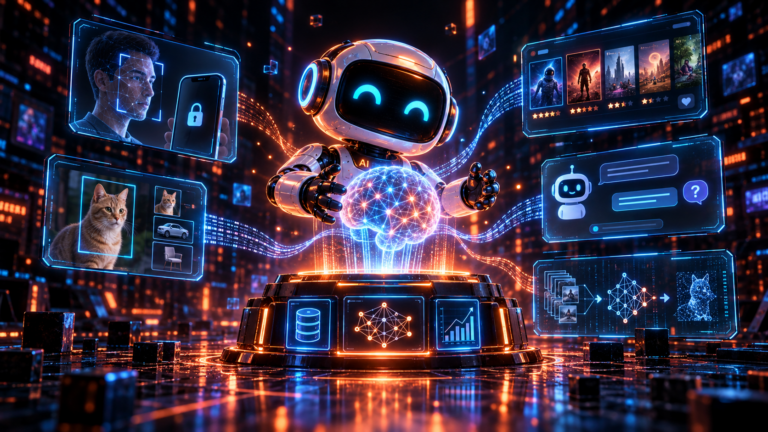
یادگیری عمیق (Deep Learning) زیرمجموعهای از یادگیری ماشین (Machine Learning) است که از شبکههای عصبی دارای چند لایه پردازشی استفاده میکند. این لایهها داده را مرحلهبهمرحله تغییر میدهند و ویژگیهای لازم برای انجام یک وظیفه را یاد میگیرند.
برای نمونه، یک برنامهی معمولی برای تشخیص تصویر حیوانی مانند یک گربه به دستورهای دقیقی درباره شکل گوش، اندازه چشم و بافت مو نیاز دارد. یک مدل یادگیری عمیق با مشاهده تصاویر برچسبگذاریشده، الگوهای مفید را در فرایند آموزش پیدا میکند و آنها را برای تشخیص تصاویر تازه به کار میگیرد.
قدرت اصلی این روش از یادگیری چندسطحی ویژگیها شکل میگیرد. مدل در داده تصویری میتواند ابتدا لبهها، سپس بافتها، بعد اجزای شیء و در پایان ساختار کلی تصویر را تشخیص دهد. همین فرایند در داده صوتی و متنی نیز با نمایشهای عددی متناسب با هر نوع داده انجام میشود.
واژه «عمیق» به چه معناست؟
واژه «عمیق» به تعداد لایههای پردازشی میان ورودی و خروجی اشاره میکند. واژهنامه یادگیری ماشین گوگل (Google Machine Learning Glossary)، هر شبکه دارای بیش از یک لایه پنهان را یک مدل عمیق معرفی میکند. شبکههای امروزی با توجه به نوع مسئله میتوانند دهها، صدها یا تعداد بیشتری لایه و بخش پردازشی داشته باشند.
عمق شبکه به مدل فرصت میدهد داده را در چند مرحله تحلیل کند. کیفیت مدل از ترکیب معماری مناسب، داده باکیفیت، روش آموزش و ارزیابی دقیق شکل میگیرد. افزایش تعداد لایهها نیز زمانی ارزش ایجاد میکند که با نیاز مسئله هماهنگ باشد.
یادگیری عمیق چه جایگاهی در هوش مصنوعی دارد؟
سه مفهوم هوش مصنوعی، یادگیری ماشین و یادگیری عمیق رابطهای سلسلهمراتبی دارند:
- هوش مصنوعی (Artificial Intelligence): مجموعه روشها و سامانههایی را در بر میگیرد که وظایفی مانند تشخیص الگو، درک زبان، برنامهریزی و تصمیمگیری را انجام میدهند.
- یادگیری ماشین (Machine Learning): بخشی از هوش مصنوعی است که در آن مدل با استفاده از داده، الگو یا رابطه موردنیاز را یاد میگیرد.
- یادگیری عمیق (Deep Learning): بخشی از یادگیری ماشین است که بر شبکههای عصبی چندلایه تکیه دارد.
رابطه این سه مفهوم به شکل «هوش مصنوعی ← یادگیری ماشین ← یادگیری عمیق» نمایش داده میشود. روشهایی مانند درخت تصمیم، رگرسیون و جنگل تصادفی نیز در یادگیری ماشین قرار میگیرند و ساختار آنها با شبکههای عصبی عمیق تفاوت دارد.
شبکه عصبی پایه یادگیری عمیق را میسازد
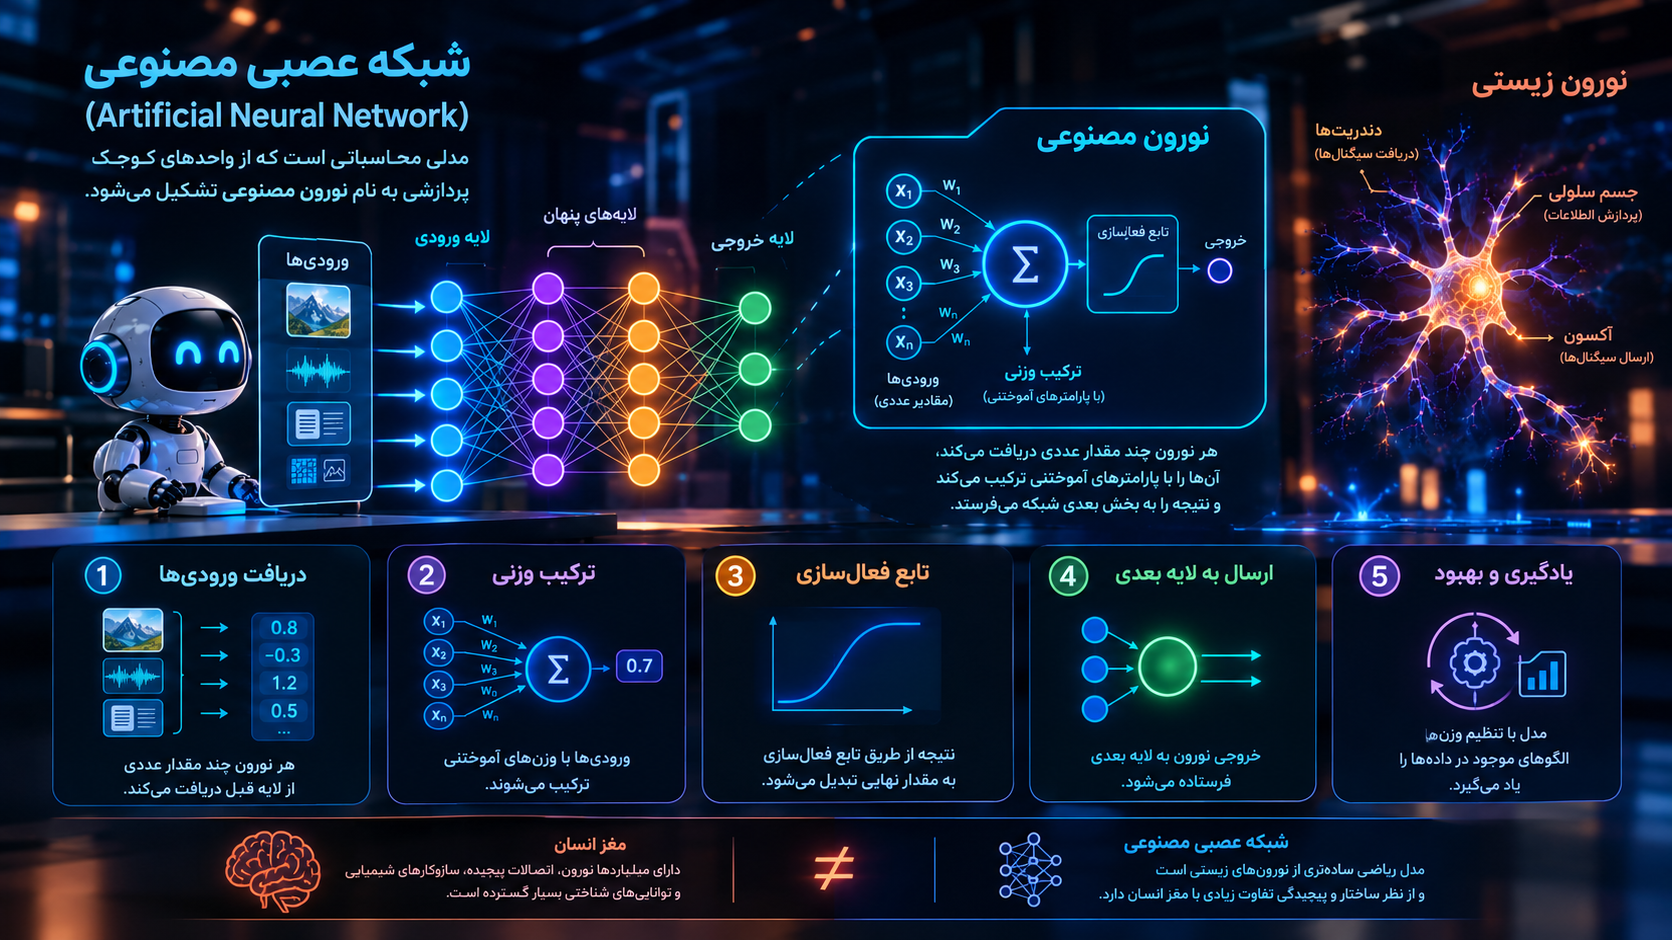
شبکه عصبی مصنوعی (Artificial Neural Network) مدلی محاسباتی است که از واحدهای کوچک پردازشی به نام نورون مصنوعی تشکیل میشود. هر نورون چند مقدار عددی دریافت میکند، آنها را با پارامترهای آموختنی ترکیب میکند و نتیجه را به بخش بعدی شبکه میفرستد.
اصطلاح «شبکه عصبی» از ایده ارتباط میان نورونهای زیستی در مغز الهام گرفته شده است. در شبکههای عصبی مصنوعی، هر نورون یک واحد محاسباتی است که با استفاده از یک تابع ریاضی، ورودیها را پردازش میکند و خروجی تولید میکند. این نورونها در لایههای مختلف به یکدیگر متصل میشوند و شبکهای را شکل میدهند که میتواند الگوهای موجود در دادهها را یاد بگیرد.
با وجود این شباهت مفهومی، شبکه عصبی مصنوعی از نظر ساختار و پیچیدگی با مغز انسان تفاوت زیادی دارد و مدل ریاضی بسیار سادهتری از سازوکار نورونهای زیستی محسوب میشود.
لایه ورودی داده را دریافت میکند
لایه ورودی داده خام یا نمایش عددی آن را دریافت میکند. تصویر به مجموعهای از مقدارهای عددی مربوط به واحدهای تصویری (Pixel) تبدیل میشود. صدا به نمونههای عددی و متن به شناسهها یا بردارهای عددی تبدیل میشود.
نوع و شکل ورودی به مسئله وابسته است. شبکه تشخیص رقم، تصویر یک عدد را دریافت میکند و شبکه پیشبینی مصرف برق، اطلاعاتی مانند ساعت، دما و مصرف روزهای گذشته را پردازش میکند.
لایههای پنهان ویژگیها را یاد میگیرند
لایههای پنهان میان ورودی و خروجی قرار میگیرند. هر لایه نتیجه لایه قبلی را دریافت میکند و نمایش تازهای از داده میسازد. لایههای ابتدایی معمولاً الگوهای سادهتر را ثبت میکنند و لایههای بعدی آنها را به ویژگیهای پیچیدهتر تبدیل میکنند.
تابع فعالسازی (Activation Function) به شبکه امکان میدهد روابط غیرخطی را یاد بگیرد. تابع فعالسازی یکسوساز خطی (ReLU) یکی از گزینههای رایج در لایههای پنهان به شمار میرود و مقدارهای منفی را به صفر تبدیل میکند.
لایه خروجی پاسخ را تولید میکند
لایه خروجی متناسب با هدف پروژه طراحی میشود. مدل تشخیص سگ و گربه میتواند برای هر گروه یک احتمال تولید کند. مدل پیشبینی دما یک مقدار عددی میسازد و مدل زبانی احتمال واژه یا بخش بعدی متن را محاسبه میکند.
تعداد خروجیها و تابع مورد استفاده در این لایه به نوع مسئله بستگی دارد. مسئله دستهبندی، پیشبینی عددی و تولید محتوا هرکدام ساختار خروجی متناسب با هدف خود را نیاز دارند.
وزن و پارامتر جابهجایی رفتار شبکه را تنظیم میکنند
هر ارتباط در شبکه یک وزن (Weight) دارد که میزان اثر اطلاعات ورودی را مشخص میکند. هر نورون میتواند پارامتر جابهجایی (Bias) نیز داشته باشد که مرز تصمیم را تنظیم میکند. آموزش شبکه در اصل فرایند پیدا کردن مقدارهای مناسب برای این پارامترها محسوب میشود.
یک شبکه بزرگ ممکن است میلیونها یا میلیاردها پارامتر داشته باشد. تعداد بیشتر پارامترها ظرفیت مدل را افزایش میدهد و همزمان به داده، توان پردازشی و کنترل دقیقتری در آموزش نیاز دارد.
یادگیری در مدل عمیق چگونه اتفاق میافتد؟
آموزش مدل عمیق از یک چرخه مشخص تشکیل میشود. داده وارد شبکه میشود، مدل پاسخ تولید میکند، مقدار خطا محاسبه میشود و پارامترهای شبکه در جهت کاهش خطا تغییر میکنند. این چرخه بارها تکرار میشود تا مدل رابطه مناسبتری میان ورودی و پاسخ پیدا کند.
داده و برچسب مسئله را تعریف میکنند
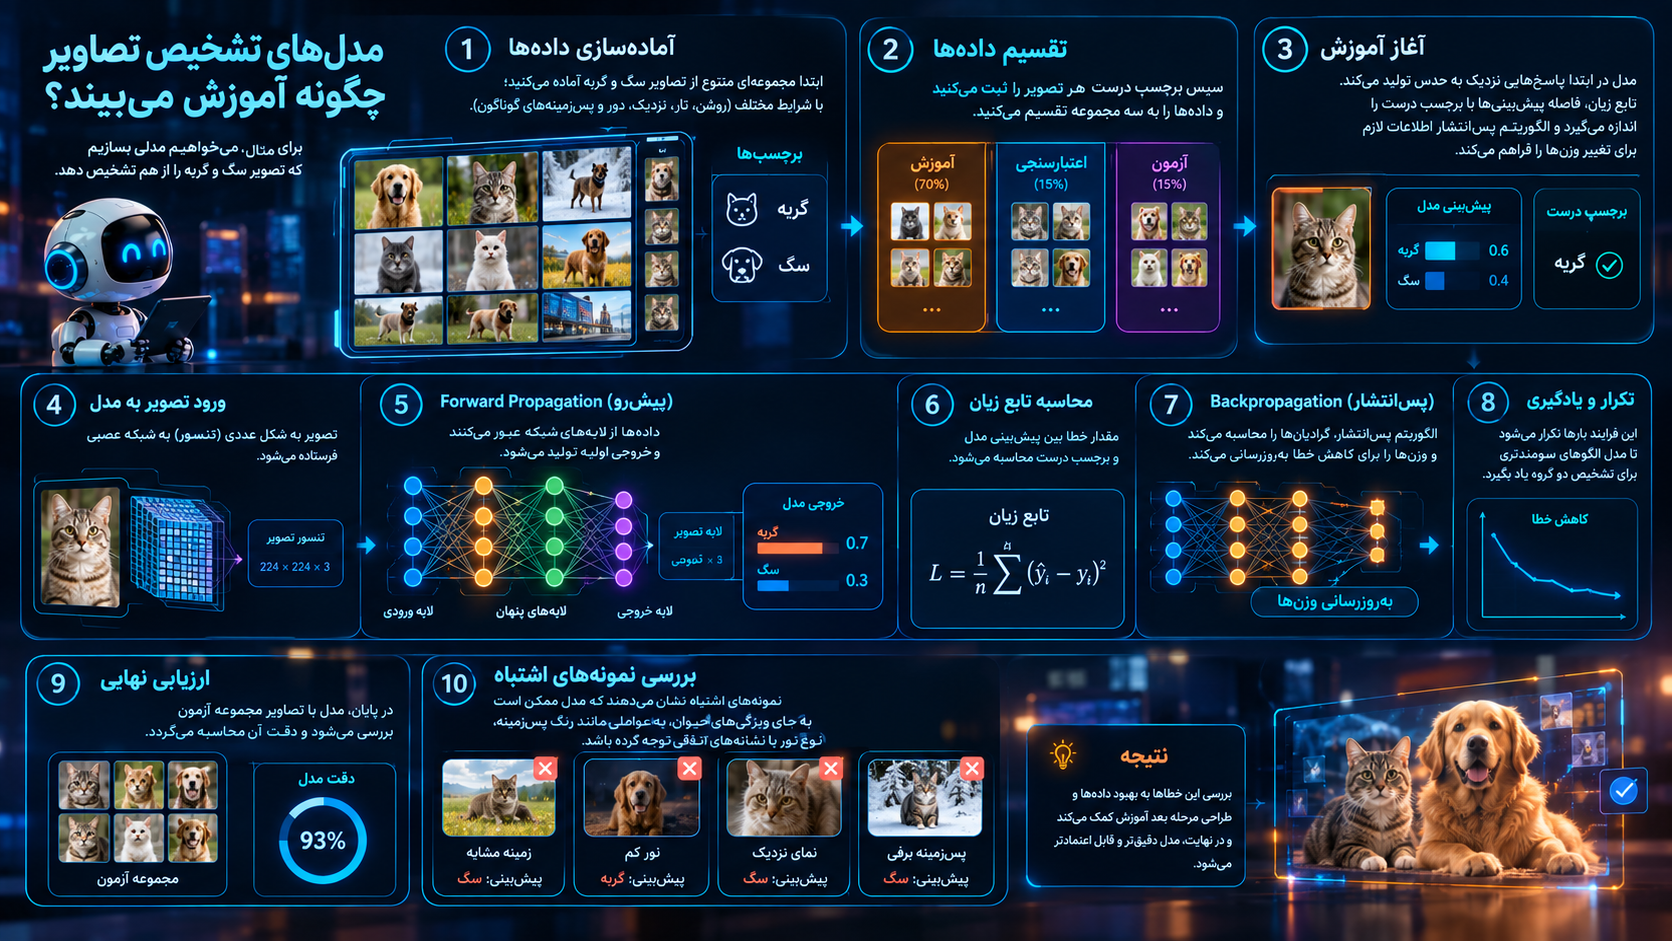
مدل برای یادگیری نظارتشده به نمونههای ورودی و پاسخ درست نیاز دارد. تصویر گربه همراه با برچسب «گربه» و تصویر سگ همراه با برچسب «سگ» یک نمونه آموزشی میسازند. کیفیت، تنوع و درستی این نمونهها بر عملکرد مدل اثر مستقیم میگذارند.
دادهها معمولاً به مجموعه آموزش (Training Set)، مجموعه اعتبارسنجی (Validation Set) و مجموعه آزمون (Test Set) تقسیم میشوند. مدل پارامترهای خود را با مجموعه آموزش یاد میگیرد، تنظیمات آن با مجموعه اعتبارسنجی بررسی میشود و عملکرد نهایی آن با مجموعه آزمون سنجیده میشود.
عبور رو به جلو پیشبینی را میسازد
در عبور رو به جلو (Forward Pass)، داده از لایه ورودی به لایههای پنهان و سپس به لایه خروجی حرکت میکند. هر لایه محاسبات خود را انجام میدهد و نتیجه را به لایه بعد میفرستد. خروجی این مسیر، پیشبینی مدل را میسازد.
مدل تشخیص تصویر ممکن است برای یک عکس، احتمال ۷۰ درصد را به گربه و احتمال ۳۰ درصد را به سگ اختصاص دهد. این خروجی در مرحله بعد با برچسب درست مقایسه میشود.
تابع زیان فاصله پاسخ را اندازه میگیرد
تابع زیان (Loss Function) اختلاف میان پیشبینی مدل و پاسخ درست را به یک عدد تبدیل میکند. پاسخ دقیقتر مقدار زیان کمتری ایجاد میکند و پاسخ ضعیفتر مقدار زیان بیشتری میسازد.
نوع تابع زیان به مسئله وابسته است. دستهبندی تصویر، پیشبینی قیمت و تولید متن از تابعهای زیان متفاوتی استفاده میکنند. انتخاب درست این تابع به مدل نشان میدهد چه نوع خطایی اهمیت بیشتری دارد.
پسانتشار سهم هر پارامتر را محاسبه میکند
الگوریتم پسانتشار (Backpropagation) مشخص میکند هر وزن و پارامتر جابهجایی چه سهمی در مقدار زیان داشته است. این الگوریتم با محاسبه شیب (Gradient)، جهت مناسب تغییر پارامترها را تعیین میکند.
بهینهساز سپس وزنها را به اندازهای کوچک تغییر میدهد. اندازه این تغییر با نرخ یادگیری (Learning Rate) کنترل میشود. نرخ مناسب به مدل کمک میکند مسیر کاهش زیان را با ثبات طی کند.
دورههای آموزش چرخه یادگیری را تکرار میکنند
هر بار پردازش کامل مجموعه آموزش یک دوره (Epoch) نام دارد. مدل در هر دوره نمونهها را پردازش میکند و پارامترهایش را تغییر میدهد. تعداد دورهها باید با توجه به روند زیان و عملکرد مدل روی دادههای اعتبارسنجی انتخاب شود.
آموزش طولانی میتواند بیشبرازش (Overfitting) ایجاد کند. در این وضعیت، مدل جزئیات دادههای آموزشی را دقیق یاد میگیرد و روی نمونههای تازه عملکرد ضعیفتری ارائه میدهد. تنوع داده، منظمسازی، توقف زودهنگام و ارزیابی پیوسته به کنترل این وضعیت کمک میکنند.
مدلهای تشخیص تصاویر چگونه آموزش میبیند؟
فرض کنید میخواهید مدلی برای دستهبندی تصویر سگ و گربه بسازید. ابتدا مجموعهای متنوع از تصاویر روشن، تار، نزدیک، دور و دارای پسزمینههای مختلف آماده میکنید. سپس برچسب درست هر تصویر را ثبت میکنید و دادهها را به سه مجموعه آموزش، اعتبارسنجی و آزمون تقسیم میکنید.
مدل در آغاز پاسخهایی نزدیک به حدس تولید میکند. تابع زیان فاصله هر پیشبینی را با برچسب درست اندازه میگیرد و الگوریتم پسانتشار اطلاعات لازم برای تغییر وزنها را فراهم میکند. تکرار این فرایند باعث میشود مدل الگوهای سودمندتری را برای تفکیک دو گروه یاد بگیرد.
ارزیابی نهایی با تصاویر مجموعه آزمون انجام میشود. بررسی نمونههای اشتباه اهمیت زیادی دارد؛ زیرا ممکن است مدل به جای ویژگیهای حیوان، رنگ پسزمینه، نوع نور یا نشانهای اتفاقی را یاد گرفته باشد. این بررسی به بهبود داده و طراحی مرحله بعد آموزش کمک میکند.
مهمترین معماریهای یادگیری عمیق کداماند؟
معماری، شیوه چیدمان لایهها و مسیر پردازش داده را مشخص میکند. تصویر، متن و داده زمانی ساختارهای متفاوتی دارند و هرکدام از نوع مناسبی از معماری بهره میبرند.
شبکه عصبی پیچشی برای تصویر کاربرد دارد
شبکه عصبی پیچشی (Convolutional Neural Network) که با نام کوتاه (CNN) شناخته میشود، الگوهای محلی تصویر را بررسی میکند. بخشهای قابلآموزش این شبکه میتوانند ویژگیهایی مانند لبه، بافت و شکل را در نواحی مختلف تصویر پیدا کنند.
این معماری در دستهبندی تصویر، تشخیص اشیا، خواندن دستخط و تحلیل برخی تصاویر پزشکی کاربرد دارد. شبکههای پیچشی همچنان ابزار مهمی در بینایی ماشین محسوب میشوند و معماریهای جدیدتری نیز در این زمینه به کار میروند.
شبکه عصبی بازگشتی دادههای ترتیبی را پردازش میکند
شبکه عصبی بازگشتی (Recurrent Neural Network) که با نام کوتاه (RNN) شناخته میشود، اطلاعات مرحلههای قبلی را در یک حالت داخلی نگهداری میکند. این ویژگی برای دادههایی کاربرد دارد که ترتیب آنها اهمیت دارد.
معماریهای حافظه بلند و کوتاهمدت (LSTM) و واحد بازگشتی دروازهدار (GRU) برای مدیریت بهتر وابستگیهای طولانیتر توسعه یافتهاند. این خانواده در پردازش سریهای زمانی، دادههای حسگر و برخی مسائل صوتی و متنی کاربرد دارد.
معماری مبتنی بر توجه ارتباط اجزای ورودی را پیدا میکند
معماری مبتنی بر توجه (Transformer) از سازوکار خودتوجهی (Self-Attention) برای محاسبه ارتباط بخشهای مختلف ورودی استفاده میکند. این معماری در مقاله «تمام آنچه نیاز دارید، توجه است» (Attention Is All You Need) در سال ۲۰۱۷ برای وظایف ترجمه ماشینی معرفی شد.
پردازش موازی و توانایی بررسی ارتباط بخشهای دور از یکدیگر، استفاده از این معماری را در متن، تصویر، صدا و دادههای چندرسانهای گسترش داده است. مدلهای مولد ازپیشآموزشدیده مبتنی بر معماری Transformer که با نام خانواده GPT شناخته میشوند، بر پایه این معماری ساخته شدهاند.
یادگیری عمیق چه کاربردهایی دارد؟
تعریف معماریها کمک میکند ارتباط میان نوع داده و کاربرد مدل روشنتر شود:
- تشخیص تصویر: شبکههای عمیق میتوانند اشیا، چهره، دستخط و نقصهای محصول را در تصویر شناسایی کنند.
- پردازش گفتار: مدلها میتوانند صدا را به متن تبدیل کنند، گوینده را تشخیص دهند و الگوهای صوتی را تحلیل کنند.
- پردازش زبان: سامانهها میتوانند متن را ترجمه، خلاصه، دستهبندی یا تولید کنند.
- سامانههای پیشنهاددهنده: مدلها میتوانند ارتباط میان کاربر و محتوا را تحلیل کنند و گزینههای مرتبطتری پیشنهاد دهند.
- پزشکی: شبکههای عمیق میتوانند در تحلیل برخی تصاویر و دادههای بالینی به متخصصان کمک کنند.
- صنعت و اینترنت اشیا: مدلها میتوانند خرابی تجهیزات، الگوهای حسگر و نیاز به تعمیر را بررسی کنند.
- بازیسازی: شبکههای عمیق میتوانند در تحلیل رفتار بازیکن، کنترل عاملهای هوشمند و ساخت برخی اجزای محتوا به کار روند.
کیفیت خروجی در هر کاربرد به داده، معماری، معیار ارزیابی و شیوه استفاده از مدل وابسته است. تصمیمهای پزشکی، حقوقی و مالی به ارزیابی تخصصی، کنترل انسانی و سنجش دقیق خطا نیاز دارند.
تفاوت یادگیری ماشین و یادگیری عمیق چیست؟
یادگیری عمیق یکی از روشهای یادگیری ماشین محسوب میشود. تفاوت اصلی آن با بسیاری از روشهای کلاسیک در استفاده از شبکههای چندلایه و توانایی یادگیری نمایشهای پیچیده از داده قرار دارد.
| یادگیری ماشین | یادگیری عمیق |
| شامل روشهایی مثل درخت تصمیم و رگرسیون است | بر شبکههای عصبی عمیق تکیه دارد |
| گاهی به مهندسی ویژگی دستی بیشتری نیاز دارد | میتواند بسیاری از نمایشهای موردنیاز را از داده یاد بگیرد |
| برای انواع مختلف مسئله قابل استفاده است | در مسائل پیچیده مثل تصویر، صدا و متن بسیار پرکاربرد است |
| بعضی مدلها با منابع محاسباتی کمتری آموزش میبینند | آموزش مدلهای عمیق بزرگ میتواند محاسبات سنگینی نیاز داشته باشد |
انتخاب مناسب از نوع مسئله، کیفیت داده، هزینه پردازش، سرعت پاسخ و نیاز به توضیحپذیری اثر میپذیرد. یک مدل ساده در مسئلهای با داده محدود یا ساختاریافته میتواند انتخاب دقیقتر و کمهزینهتری باشد.
مزایا و محدودیتهای یادگیری عمیق کداماند؟
یادگیری عمیق میتواند نمایشهای چندسطحی را مستقیماً از داده یاد بگیرد و روابط پیچیده را مدلسازی کند. این ویژگی در پروژههایی با تصویر، صدا و متن ارزش زیادی ایجاد میکند. شبکههای عمیق همچنین از داده و توان پردازشی بیشتر برای افزایش ظرفیت یادگیری بهره میبرند.
این روش به داده مناسب، زمان آموزش و منابع محاسباتی نیاز دارد. مدلهای بزرگ انرژی و حافظه بیشتری مصرف میکنند و تحلیل دلیل بعضی تصمیمهای آنها دشوارتر است. داده نامتوازن یا برچسب اشتباه نیز میتواند الگوهای نامناسبی در مدل ایجاد کند.
توسعهدهنده باید عملکرد مدل را روی داده تازه بررسی کند، خطاها را بر اساس گروههای مختلف بسنجد و محدودیتهای کاربرد را ثبت کند. این مراحل قابلیت اعتماد پروژه را افزایش میدهند.
ابزارهای یادگیری عمیق چه کاربردی دارند؟
ابزارهای این بخش نقشهای متفاوتی دارند. بعضی محیط اجرای کد فراهم میکنند و بعضی ساخت، آموزش و ارزیابی شبکه عصبی را سادهتر میسازند.
| ابزار | ماهیت و کاربرد | وضعیت استفاده |
| زبان برنامهنویسی (Python) | برای آمادهسازی داده، ساخت مدل و اجرای کتابخانههای یادگیری عمیق به کار میرود | رایگان و متنباز عرضه میشود |
| دفترچه ابری گوگل (Google Colab) | کدهای زبان برنامهنویسی (Python) را بدون نصب در مرورگر اجرا میکند و برای تمرین و پروژههای کوچک مناسب است | نسخه رایگان با منابع و سهمیه متغیر دارد و طرحهای پولی نیز ارائه میکند |
| چارچوب یادگیری ماشین (TensorFlow) و رابط ساخت مدل (Keras) | ابزارهای لازم برای تعریف لایهها، آموزش مدل و ارزیابی نتیجه را فراهم میکنند | رایگان و متنباز عرضه میشوند |
| چارچوب یادگیری عمیق (PyTorch) | برای ساخت شبکههای عصبی، کنترل فرایند آموزش و انجام پروژههای آموزشی و پژوهشی به کار میرود | رایگان و متنباز عرضه میشود |
ترکیب دفترچه ابری گوگل (Google Colab)، زبان برنامهنویسی (Python) و رابط ساخت مدل (Keras) مسیر سادهای برای نخستین تجربه فراهم میکند. چارچوب یادگیری عمیق (PyTorch) نیز آموزش رسمی مرحلهبهمرحلهای برای کار با داده، ساخت مدل، بهینهسازی پارامترها و ذخیره نتیجه ارائه میکند.
نسخه رایگان دفترچه ابری گوگل (Google Colab) دسترسی به منابع پردازشی را فراهم میکند و مقدار این منابع در طول زمان تغییر میکند. پروژههای آموزشی کوچک معمولاً با پردازنده مرکزی اجرا میشوند و پروژههای تصویری سنگینتر میتوانند از پردازنده گرافیکی بهره ببرند.
نخستین پروژه یادگیری عمیق را چگونه شروع کنیم؟
پروژه تشخیص ارقام دستنویس، پروژهای مناسب برای تجربه چرخه کامل یادگیری عمیق محسوب میشود. مجموعه داده ارقام دستنویس (MNIST) تصاویر کوچک اعداد صفر تا ۹ را همراه با برچسب درست هر تصویر در اختیار شما قرار میدهد.
- محیط اجرا را آماده کنید: یک دفترچه تازه در دفترچه ابری گوگل (Google Colab) بسازید و محیط زبان برنامهنویسی (Python) را فعال کنید.
- داده را دریافت کنید: مجموعه داده ارقام دستنویس (MNIST) را از طریق رابط ساخت مدل (Keras) بارگذاری کنید و شکل دادهها و برچسبها را بررسی کنید.
- مقادیر تصویر را مقیاسبندی کنید: مقدار هر واحد تصویری (Pixel) را به بازه صفر تا یک تبدیل کنید تا آموزش پایدارتر انجام شود.
- شبکه را بسازید: تصویر را به بردار تبدیل کنید، یک لایه پنهان با تابع یکسوساز خطی (ReLU) بسازید و برای ده رقم، ده خروجی تعریف کنید.
- مدل را آموزش دهید: تعداد محدودی دوره آموزشی اجرا کنید و روند زیان و دقت را روی مجموعه آموزش و اعتبارسنجی بررسی کنید.
- نتیجه را ارزیابی کنید: دقت مجموعه آزمون و نمونههای اشتباه را مشاهده کنید و الگوهای خطا را یادداشت کنید.
هدف پروژه نخست، شناخت چرخه کامل ساخت مدل است. بررسی مسیر داده، شکل ورودی، ساختار شبکه، تابع زیان، آموزش و ارزیابی ارزش آموزشی پروژه را افزایش میدهد. تغییر تعداد نورونها یا دورههای آموزش نیز اثر تنظیمات را بهصورت عملی نشان میدهد.
مسیر یادگیری عمیق برای دانشآموزان چگونه است؟
شروع مناسب از زبان برنامهنویسی (Python)، متغیرها، شرطها، حلقهها، تابعها و آرایهها شکل میگیرد. پس از آن، مفاهیم داده آموزشی، برچسب، دستهبندی، معیار ارزیابی و بیشبرازش پایه لازم برای ورود به شبکه عصبی را فراهم میکنند.
در مرحله بعد میتوانید ساختار نورون، لایه، تابع فعالسازی، تابع زیان و فرایند پسانتشار را یاد بگیرید. اجرای یک پروژه کوچک با رابط ساخت مدل (Keras) یا چارچوب یادگیری عمیق (PyTorch) ارتباط میان این مفاهیم را روشن میکند.
جبر پایه و شناخت تابعها برای شروع مفهومی کفایت میکنند. بردار و ماتریس، احتمال و مشتق در مراحل تخصصیتر به تحلیل دقیقتر آموزش شبکه کمک میکنند. یادگیری همزمان مفهوم و پروژه، مسیر پیشرفت را منظمتر و ماندگارتر میسازد.
جمعبندی
یادگیری عمیق روشی در یادگیری ماشین است که با شبکههای عصبی چندلایه، نمایشهای پیچیده را از داده یاد میگیرد. داده از لایههای شبکه عبور میکند، تابع زیان کیفیت پیشبینی را اندازه میگیرد و الگوریتم پسانتشار پارامترها را اصلاح میکند.
شناخت معماریهای پیچشی، بازگشتی و مبتنی بر توجه به شما کمک میکند رابطه میان ساختار مدل و نوع داده را درک کنید. شروع با زبان برنامهنویسی (Python)، دفترچه ابری گوگل (Google Colab) و یک پروژه کوچک مانند تشخیص ارقام دستنویس، مسیر مناسبی برای تبدیل مفاهیم مقاله به تجربه عملی فراهم میکند.
پرسشهای رایج درباره یادگیری عمیق
آیا یادگیری عمیق همان هوش مصنوعی است؟
یادگیری عمیق یکی از بخشهای یادگیری ماشین و یادگیری ماشین یکی از بخشهای هوش مصنوعی محسوب میشود. هوش مصنوعی روشهای دیگری مانند جستوجو، برنامهریزی و سامانههای قاعدهمحور را نیز در بر میگیرد.
آیا برای یادگیری عمیق به ریاضی پیشرفته نیاز داریم؟
جبر پایه و شناخت تابعها برای درک مفهومی و اجرای پروژههای مقدماتی کافی هستند. جبر خطی، احتمال و مشتق در مراحل پیشرفتهتر به فهم دقیق محاسبات و فرایند آموزش کمک میکنند.
تفاوت شبکه عصبی و یادگیری عمیق چیست؟
شبکه عصبی میتواند ساختاری کمعمق یا عمیق داشته باشد. یادگیری عمیق به استفاده از شبکههای دارای چند لایه پنهان و روشهای مرتبط با آموزش آنها اشاره میکند.
آیا همه پروژهها به یادگیری عمیق نیاز دارند؟
نوع داده، اندازه مجموعه داده، هزینه محاسبات، سرعت و توضیحپذیری انتخاب مدل را مشخص میکنند. روشهای سادهتر در بسیاری از مسائل ساختاریافته با داده محدود، نتیجه دقیق و قابلتحلیلتری تولید میکنند.
مدلهای زبانی چه ارتباطی با یادگیری عمیق دارند؟
مدلهای زبانی بزرگ با شبکههای عصبی عمیق آموزش میبینند. بسیاری از مدلهای امروزی از معماری مبتنی بر توجه (Transformer) استفاده میکنند و خانواده مدلهای زبانی مولد ازپیشآموزشدیده (GPT) نیز در این گروه قرار میگیرد.