



همین نگاه، به شکلگیری ایدهای انجامید که امروز آن را با نام تورینگ تست در هوش مصنوعی میشناسیم. در این مطلب، قدمبهقدم بررسی میکنیم آزمون تورینگ دقیقاً چیست، چه چیزی را میسنجد، چرا مورد انتقاد قرار گرفته و آیا در سال ۲۰۲۶ هنوز میتوان آن را معیاری معتبر برای سنجش هوش مصنوعی دانست یا نه.
سؤال معروف «آیا ماشین میتواند فکر کند» از کجا آمد؟
در میانه قرن بیستم، رایانهها هنوز با سیستمهای هوش مصنوعی امروزی تفاوت بسیار زیادی داشتند. بخش مهمی از توانایی آنها به محاسبات و اجرای دستورهای از پیش تعیینشده مربوط میشد و ایده اینکه یک ماشین بتواند رفتاری شبیه تفکر انسان داشته باشد، هنوز موضوعی بحثبرانگیز بود.
در همین فضا، آلن تورینگ در مقاله مشهور خود با عنوان Computing Machinery and Intelligence که در سال ۱۹۵۰ منتشر شد، بحث را با یک سؤال ساده آغاز کرد: «آیا ماشینها میتوانند فکر کنند؟» اما تورینگ خیلی زود متوجه شد که تعریف دقیق واژههایی مانند «ماشین» و «فکر کردن» میتواند خود به یک مسئله پیچیده تبدیل شود. به همین دلیل، بهجای تلاش برای ارائه یک تعریف مستقیم، پیشنهاد کرد این سؤال به شکل دیگری مطرح شود.
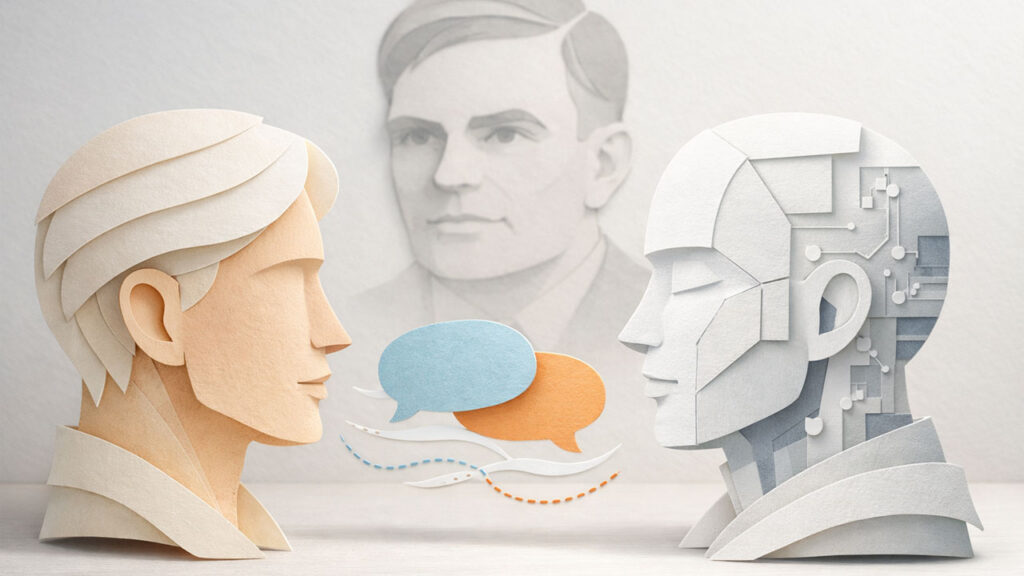
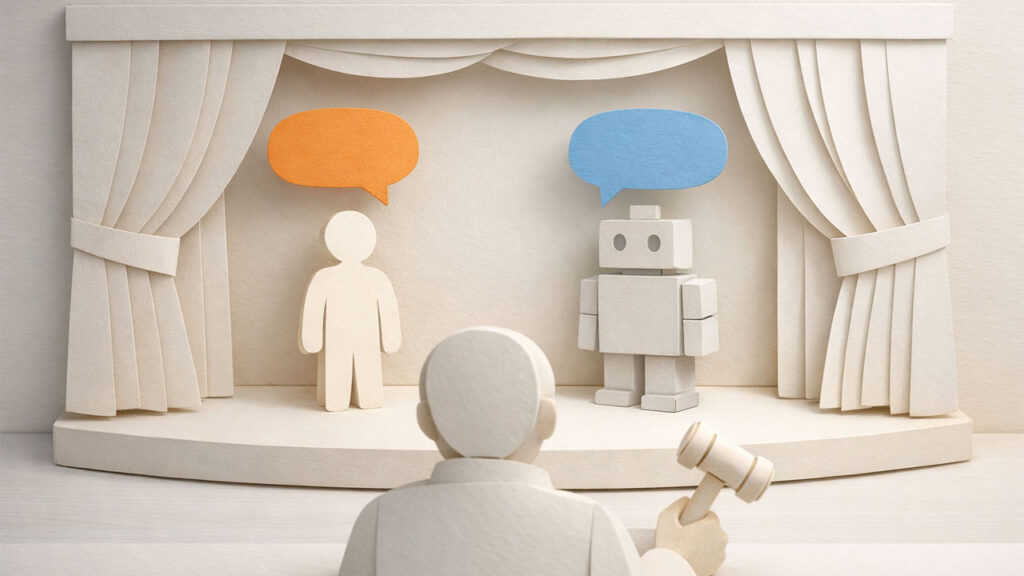
اینجا ایده «بازی تقلید» (Imitation Game) مطرح شد. تورینگ بهجای اینکه بخواهد مستقیماً به ذهن یا آگاهی یک ماشین دسترسی پیدا کند، توجه خود را به رفتار قابل مشاهده و نحوه پاسخگویی آن معطوف کرد. در نسخه اصلی بازی، یک پرسشگر از طریق ارتباط نوشتاری با دو شرکتکننده در ارتباط است و باید تشخیص دهد کدامیک از آنها مرد و کدامیک زن است. تورینگ سپس این ساختار را به مسئله ماشین تعمیم داد و پرسید اگر یکی از طرفین ماشین باشد، آیا پرسشگر میتواند آن را از انسان تشخیص دهد؟
بنابراین، ایده اصلی تورینگ این نبود که ثابت کند ماشین دقیقاً مانند انسان «فکر» میکند. او تلاش کرد یک معیار رفتاری و عملی برای بحث درباره هوش ماشین ارائه دهد؛ معیاری که بهجای ورود مستقیم به مفاهیمی مانند ذهن و آگاهی، بر توانایی ماشین در شبیهسازی رفتار و گفتوگوی انسانی تمرکز دارد.
همین تغییر زاویه دید، یکی از مهمترین نقاط شکلگیری چیزی شد که امروزه آن را آزمون تورینگ مینامیم؛ آزمونی که بیش از هفت دهه بعد، همچنان یکی از شناختهشدهترین مفاهیم در تاریخ هوش مصنوعی و فلسفه ذهن است.
آلن تورینگ چه نقشی در شکلگیری هوش مصنوعی داشت؟
آلن تورینگ یکی از چهرههای مهم در شکلگیری مباحث نظری مرتبط با محاسبات و هوش ماشین بود. علاقه او فقط به ساخت ماشینی شبیه انسان محدود نمیشد؛ بلکه مسئله بنیادیتر این بود که آیا میتوان فرایندهای حل مسئله و انجام محاسبات را به شکلی رسمی و قابل اجرا توسط ماشین توصیف کرد؟
تورینگ در دهه ۱۹۳۰ با معرفی مفهوم ماشین تورینگ (Turing Machine) به بررسی این موضوع پرداخت که چه نوع مسائلی را میتوان با یک فرایند محاسباتی مشخص حل کرد. این ایده بعدها به یکی از پایههای نظری علوم کامپیوتر تبدیل شد.
سالها بعد، تورینگ این بحث را به موضوع هوش ماشین گسترش داد. او در مقاله سال ۱۹۵۰ خود، بهجای تلاش برای تعریف دقیق واژه «فکر کردن»، پیشنهاد کرد توانایی ماشین را از طریق رفتار قابل مشاهده در یک گفتوگوی متنی بررسی کنیم. این دیدگاه زمینهساز ایدهای شد که بعدها با عنوان آزمون تورینگ شناخته شد.
بنابراین، نقش تورینگ در شکلگیری هوش مصنوعی را میتوان در دو مسیر مهم دید: نخست، کمک به شکلگیری مبانی نظری محاسبات و علوم کامپیوتر و دوم، مطرح کردن این پرسش که آیا میتوان هوشمندی ماشین را بر اساس رفتار آن ارزیابی کرد.
البته تورینگ بهتنهایی بنیانگذار تمام حوزه هوش مصنوعی نبود؛ این حوزه بعدها با مشارکت پژوهشگران مختلف و بهویژه با شکلگیری رسمی اصطلاح Artificial Intelligence در دهه ۱۹۵۰ توسعه پیدا کرد. با این حال، ایدهها و پرسشهای مطرحشده توسط تورینگ نقش مهمی در شکلگیری بحثهای اولیه درباره امکان هوشمندی ماشینها داشتند.
تورینگ تست در هوش مصنوعی دقیقاً چه چیزی را میسنجد؟
تورینگ تست قرار نیست مشخص کند یک ماشین «واقعاً» فکر میکند یا نه. این نکته مهمی درباره ماهیت این آزمون است. آزمون تورینگ مستقیماً ذهن، احساسات یا آگاهی ماشین را اندازهگیری نمیکند؛ بلکه بر رفتار قابل مشاهده ماشین در یک گفتوگوی متنی تمرکز دارد.
ایده آزمون نسبتاً ساده است. یک داور انسانی با دو طرف گفتوگو میکند؛ یکی انسان است و دیگری ماشین. داور از هویت طرفین مطلع نیست و فقط بر اساس پاسخهایی که دریافت میکند، تلاش میکند تشخیص دهد کدام طرف انسان و کدام طرف ماشین است. اگر عملکرد ماشین به اندازهای شبیه انسان باشد که داور نتواند با اطمینان آن را از انسان تشخیص دهد، میتوان گفت ماشین در چارچوب آن آزمون موفق بوده است.
بنابراین، آزمون تورینگ را بهتر است معیاری برای سنجش توانایی ماشین در شبیهسازی رفتار گفتوگویی انسان بدانیم، نه آزمونی برای اندازهگیری مستقیم آگاهی یا هوش درونی. این آزمون نمیپرسد ماشین واقعاً میفهمد، احساس میکند یا آگاه است؛ بلکه بررسی میکند آیا رفتار و پاسخهای آن در یک تعامل زبانی میتواند از رفتار یک انسان قابل تشخیص نباشد یا خیر.
همین ویژگی، هم یکی از نقاط قوت آزمون تورینگ و هم منشأ بخش مهمی از انتقادهای واردشده به آن است. زیرا ممکن است یک ماشین بتواند در یک گفتوگو رفتاری شبیه انسان نشان دهد، بدون اینکه این موضوع بهتنهایی چیزی درباره آگاهی، درک یا نحوه پردازش درونی آن اثبات کند.
آیا تست تورینگ در سال ۲۰۲۶ هنوز معتبر است؟
برای پاسخ به این سؤال، اول باید روشن شود وقتی از «اعتبار» حرف میزنیم دقیقاً چه منظوری داریم. اگر منظور این باشد که آزمون تورینگ هنوز میتواند بحثهای مهمی درباره هوش مصنوعی ایجاد کند، پاسخ مثبت است. اما اگر انتظار داشته باشیم این آزمون بهتنهایی بتواند میزان هوشمندی یک سیستم را مشخص کند، چنین انتظاری با شرایط امروز هوش مصنوعی سازگار نیست.
در سال ۲۰۲۶، بسیاری از سیستمهای هوش مصنوعی میتوانند گفتوگوهای طولانی و طبیعی انجام دهند و در موقعیتهای مختلف انسان را دچار تردید کنند. این توانایی بیشتر نتیجه پیشرفت در پردازش زبان و شناسایی الگوهای آماری است و الزاماً به معنای تفکر یا درک واقعی نیست.
به همین دلیل، امروزه آزمون تورینگ بیش از آنکه معیار نهایی سنجش هوش مصنوعی باشد، بهعنوان یک نقطه شروع تاریخی برای طرح این بحث شناخته میشود.
آیا هوش مصنوعیهای امروزی تست تورینگ را پشت سر گذاشتهاند؟
پاسخ به این سؤال به نحوه طراحی آزمون بستگی دارد. در سالهای اخیر، چندین آزمایش نشان دادهاند که بعضی مدلهای زبانی میتوانند در شرایط مشخص، به اندازهای شبیه انسان گفتوگو کنند که داوران انسانی در تشخیص آنها دچار خطا شوند.
برای مثال، در یک مطالعه کنترلشده و پیشثبتشده در سال ۲۰۲۵، پژوهشگران GPT-۴.۵ را در یک آزمون تورینگ سهنفره آزمایش کردند. شرکتکنندگان به مدت پنج دقیقه با یک انسان و یک سیستم هوش مصنوعی گفتوگو کردند و سپس باید تشخیص میدادند کدام طرف انسان است. در شرایطی که GPT-۴.۵ با یک شخصیت انسانی مشخص هدایت شده بود، داوران در ۷۳ درصد موارد آن را بهعنوان انسان انتخاب کردند. در همان مطالعه، عملکرد مدلهای دیگر متفاوت بود؛ بنابراین نمیتوان نتیجه را به همه مدلهای هوش مصنوعی تعمیم داد.
این نتایج نشان میدهند که عبور از یک نسخه مشخص از آزمون تورینگ دیگر صرفاً یک فرض نظری نیست. با این حال، نمیتوان گفت هوش مصنوعی بهطور مطلق «آزمون تورینگ را پشت سر گذاشته است». نتیجه آزمون به عواملی مانند مدت گفتوگو، نوع پرسشها، نحوه انتخاب داوران، اطلاعاتی که در اختیار مدل قرار میگیرد و معیار مورد استفاده برای موفقیت بستگی دارد.
حتی پژوهشهای دیگری که در سال ۲۰۲۵ انجام شدهاند، نشان دادهاند که وقتی آزمون با گفتوگوهای طولانیتر و شرایط پیچیدهتر طراحی شود، تشخیص تفاوت میان انسان و هوش مصنوعی میتواند آسانتر شود. بنابراین، یک مدل ممکن است در یک نسخه از آزمون موفق باشد اما در یک آزمون سختتر یا با پروتکل متفاوت، نتیجه دیگری به دست آورد.
به همین دلیل، بهتر است درباره نتایج آزمون تورینگ با دقت صحبت کنیم: برخی مدلهای هوش مصنوعی در برخی پیادهسازیهای آزمون توانستهاند از انسان قابل تشخیص نباشند، اما این موفقیت بهتنهایی ثابت نمیکند که ماشین دارای درک، آگاهی یا تفکر انسانی است.
در واقع، همین تفاوت میان «شبیه انسان رفتار کردن» و «داشتن هوش یا درک انسانی» یکی از مهمترین دلایلی است که باعث شده اعتبار و محدودیتهای آزمون تورینگ همچنان مورد بحث باشد.
جایگزین تست تورینگ در AI چیست؟
با گسترش مدلهای هوش مصنوعی، مشخص شد که یک آزمون واحد مانند آزمون تورینگ نمیتواند تمام ابعاد توانایی یک سیستم هوشمند را اندازهگیری کند. به همین دلیل، امروزه بهجای یک جایگزین واحد برای تست تورینگ، از مجموعهای از معیارها و روشهای ارزیابی استفاده میشود که هرکدام بخش مشخصی از تواناییهای AI را میسنجند.
یکی از این رویکردها، ارزیابی دانش و استدلال است. در این روش، مدل با مجموعهای از مسائل استاندارد در حوزههایی مانند علوم، ریاضیات و استدلال منطقی آزمایش میشود. بنچمارکهایی مانند MMLU، GPQA و MMMU نمونههایی از این نوع ارزیابی هستند. با این حال، عملکرد خوب در یک بنچمارک بهتنهایی به معنای برخورداری از هوش عمومی یا درک انسانی نیست.
رویکرد دیگر، سنجش توانایی حل مسئله و تعمیم است. در اینجا بررسی میشود که آیا سیستم میتواند دانستهها و مهارتهای خود را در مسائل یا موقعیتهای جدید به کار بگیرد یا عملکرد آن عمدتاً به الگوهای آشنا و دادههای مشابه محدود میشود.
همچنین ارزیابیها بیش از گذشته به سمت عملکرد در وظایف واقعی حرکت کردهاند. برای مثال، بنچمارکهایی مانند SWE-bench توانایی مدلها را در حل مسائل واقعی نرمافزاری بررسی میکنند و بنچمارکهایی مانند OSWorld عملکرد سیستمهای هوش مصنوعی را در انجام وظایف روی رایانه ارزیابی میکنند. گزارش AI Index ۲۰۲۶ نیز نشان میدهد که با افزایش توانایی مدلها، توجه پژوهشگران بیشتر به ارزیابی وظایف پیچیده و کاربردهای واقعی معطوف شده است.
در کنار این موارد، ارزیابی انسانی، ایمنی، قابلیت اطمینان و میزان موفقیت در کاربردهای واقعی نیز اهمیت بیشتری پیدا کردهاند. به همین دلیل، امروزه بهجای اینکه بپرسیم «آیا این AI آزمون تورینگ را قبول میشود؟»، معمولاً سؤال دقیقتر این است که این سیستم در چه نوع وظایفی، با چه دقتی و تحت چه شرایطی میتواند عملکرد قابل اعتماد داشته باشد؟
بنابراین، آزمون تورینگ هنوز یک مفهوم تاریخی و مهم در بحث هوش ماشین است، اما ارزیابی هوش مصنوعی مدرن به یک آزمون واحد محدود نمیشود و از مجموعهای از بنچمارکها، آزمونهای تخصصی و ارزیابیهای دنیای واقعی استفاده میکند.
چرا هنوز از آزمون تورینگ صحبت میکنیم؟
با وجود تمام انتقادها و محدودیتها، آزمون تورینگ همچنان از بحثهای هوش مصنوعی کنار نرفته است. دلیلش این نیست که این آزمون کامل یا بینقص است، بلکه به این خاطر است که یک سؤال ساده و قابلفهم را مطرح میکند؛ سؤالی که حتی بدون دانش فنی هم میشود با آن ارتباط گرفت.
آزمون تورینگ کمک میکند درباره مرز میان انسان و ماشین فکر کنیم. این آزمون به ما یادآوری میکند که شباهت رفتاری همیشه به معنای درک واقعی نیست و نباید صرفاً بر اساس ظاهر قضاوت کرد. به همین دلیل، هنوز هم در بحثهای مربوط به هوش مصنوعی و آگاهی از آن استفاده میشود.
در واقع، آزمون تورینگ بیش از آنکه یک ابزار اندازهگیری باشد، یک نقطه شروع برای فکر کردن است. آزمونی که مسیر پرسشها را مشخص کرد و هنوز هم ما را وادار میکند درباره معنای هوش، تفکر و نقش ماشینها در آینده بیشتر تأمل کنیم.
جمعبندی
آزمون تورینگ از یک سؤال ساده شروع شد، اما به یکی از ماندگارترین بحثها در تاریخ هوش مصنوعی تبدیل شد. این آزمون هیچوقت قرار نبود ثابت کند ماشین واقعاً فکر میکند یا آگاه است؛ هدفش این بود که مرز میان رفتار انسانی و رفتار ماشینی را به چالش بکشد.
امروز، با وجود پیشرفت چشمگیر هوش مصنوعی، مشخص شده که تست تورینگ بهتنهایی معیار کاملی برای سنجش هوشمندی نیست. با این حال، ارزش آن از بین نرفته است. این آزمون هنوز به ما کمک میکند سؤالهای درستی بپرسیم و تفاوت میان «شبیه انسان بودن» و «فهمیدن واقعی» را جدی بگیریم.
به همین دلیل، آزمون تورینگ همچنان زنده است؛ نه بهعنوان پاسخ نهایی، بلکه بهعنوان نقطهای که هر بحث جدی درباره هوش مصنوعی از آن شروع میشود.
پرسشهای متداول درباره آزمون تورینگ
آیا تورینگ تست ثابت میکند که ماشین واقعاً فکر میکند؟
خیر. آزمون تورینگ قرار نیست مشخص کند که یک ماشین واقعاً آگاهی یا درک انسانی دارد. این آزمون بررسی میکند که آیا پاسخهای ماشین آنقدر شبیه پاسخهای انسان هستند که داور نتواند بهراحتی آن را از انسان تشخیص دهد یا خیر.
آیا هوش مصنوعیهای امروزی تست تورینگ را پشت سر گذاشتهاند؟
برخی مدلهای هوش مصنوعی در شرایط و نسخههای مشخصی از آزمون توانستهاند عملکردی داشته باشند که تشخیص آنها از انسان برای داوران دشوار باشد. با این حال، نتیجه به نحوه طراحی آزمون و شرایط گفتوگو بستگی دارد.
چرا آزمون تورینگ مورد انتقاد قرار گرفته است؟
چون این آزمون بیشتر رفتار قابل مشاهده و توانایی شبیهسازی گفتوگوی انسانی را میسنجد، نه آگاهی یا درک واقعی. بنابراین ممکن است یک سیستم بدون داشتن درک انسانی، پاسخهایی تولید کند که طبیعی به نظر برسند.
اگر تورینگ تست کافی نیست، چگونه هوش مصنوعی را ارزیابی میکنند؟
امروزه از مجموعهای از معیارها استفاده میشود؛ از جمله آزمونهای استدلال، سنجش توانایی تعمیم، ارزیابی مهارتهای تخصصی و بررسی عملکرد سیستم در وظایف واقعی.
چرا با وجود محدودیتها هنوز از آزمون تورینگ صحبت میشود؟
چون آزمون تورینگ یک پرسش بنیادین درباره رابطه میان رفتار هوشمندانه و هوش واقعی مطرح میکند و به یکی از مفاهیم مهم در تاریخ هوش مصنوعی تبدیل شده است.
آزمون تورینگ را چه کسی مطرح کرد؟
آزمون تورینگ توسط آلن تورینگ در مقاله معروف او با عنوان Computing Machinery and Intelligence در سال ۱۹۵۰ مطرح شد.
آزمون تورینگ چگونه انجام میشود؟
در شکل کلاسیک آزمون، یک داور انسانی از طریق ارتباط نوشتاری با طرفهای دیگر تعامل دارد و تلاش میکند تشخیص دهد کدام طرف انسان و کدام طرف ماشین است.
آیا آزمون تورینگ فقط برای چتباتها کاربرد دارد؟
آزمون اصلی تورینگ بر تعامل زبانی و توانایی ماشین در شبیهسازی گفتوگوی انسانی تمرکز دارد. بنابراین بیشترین ارتباط را با سیستمهایی دارد که میتوانند با انسان بهصورت مکالمهای تعامل کنند.
تفاوت آزمون تورینگ با بنچمارکهای هوش مصنوعی چیست؟
آزمون تورینگ بر توانایی ماشین برای قابلتشخیص نبودن از انسان در یک تعامل تمرکز دارد، درحالیکه بنچمارکهای مدرن معمولاً تواناییهای مشخصی مانند استدلال، حل مسئله، برنامهنویسی یا انجام وظایف واقعی را اندازهگیری میکنند.
آیا قبولی در آزمون تورینگ به معنی هوش عمومی مصنوعی است؟
خیر. موفقیت در آزمون تورینگ فقط نشان میدهد که سیستم در شرایط آزمون توانسته رفتاری شبیه انسان نشان دهد و بهتنهایی اثباتکننده وجود هوش عمومی، آگاهی یا درک انسانی نیست.
یک پاسخ
راستش بنظرم ما هیچ وقت نمیتونیم به این سوال پاسخ بدیم که چطور فکر میکنیم
ولی میتونیم به این سوال پاسخ بدیم که به چه چیزی فکر میکنیم